以后替你上网的,可能是 AI。
你说一句「帮我看看这个视频讲了什么」「帮我订个周六的位子」,AI 助手自己去打开网站、读页面、点按钮。业内管它叫 agent。
问题是,网站准备好接待它了吗?
11 月 19 号凌晨,我用自己刚开源的工具 agent-friendly,把 15 个大站的首页挨个扫了一遍。
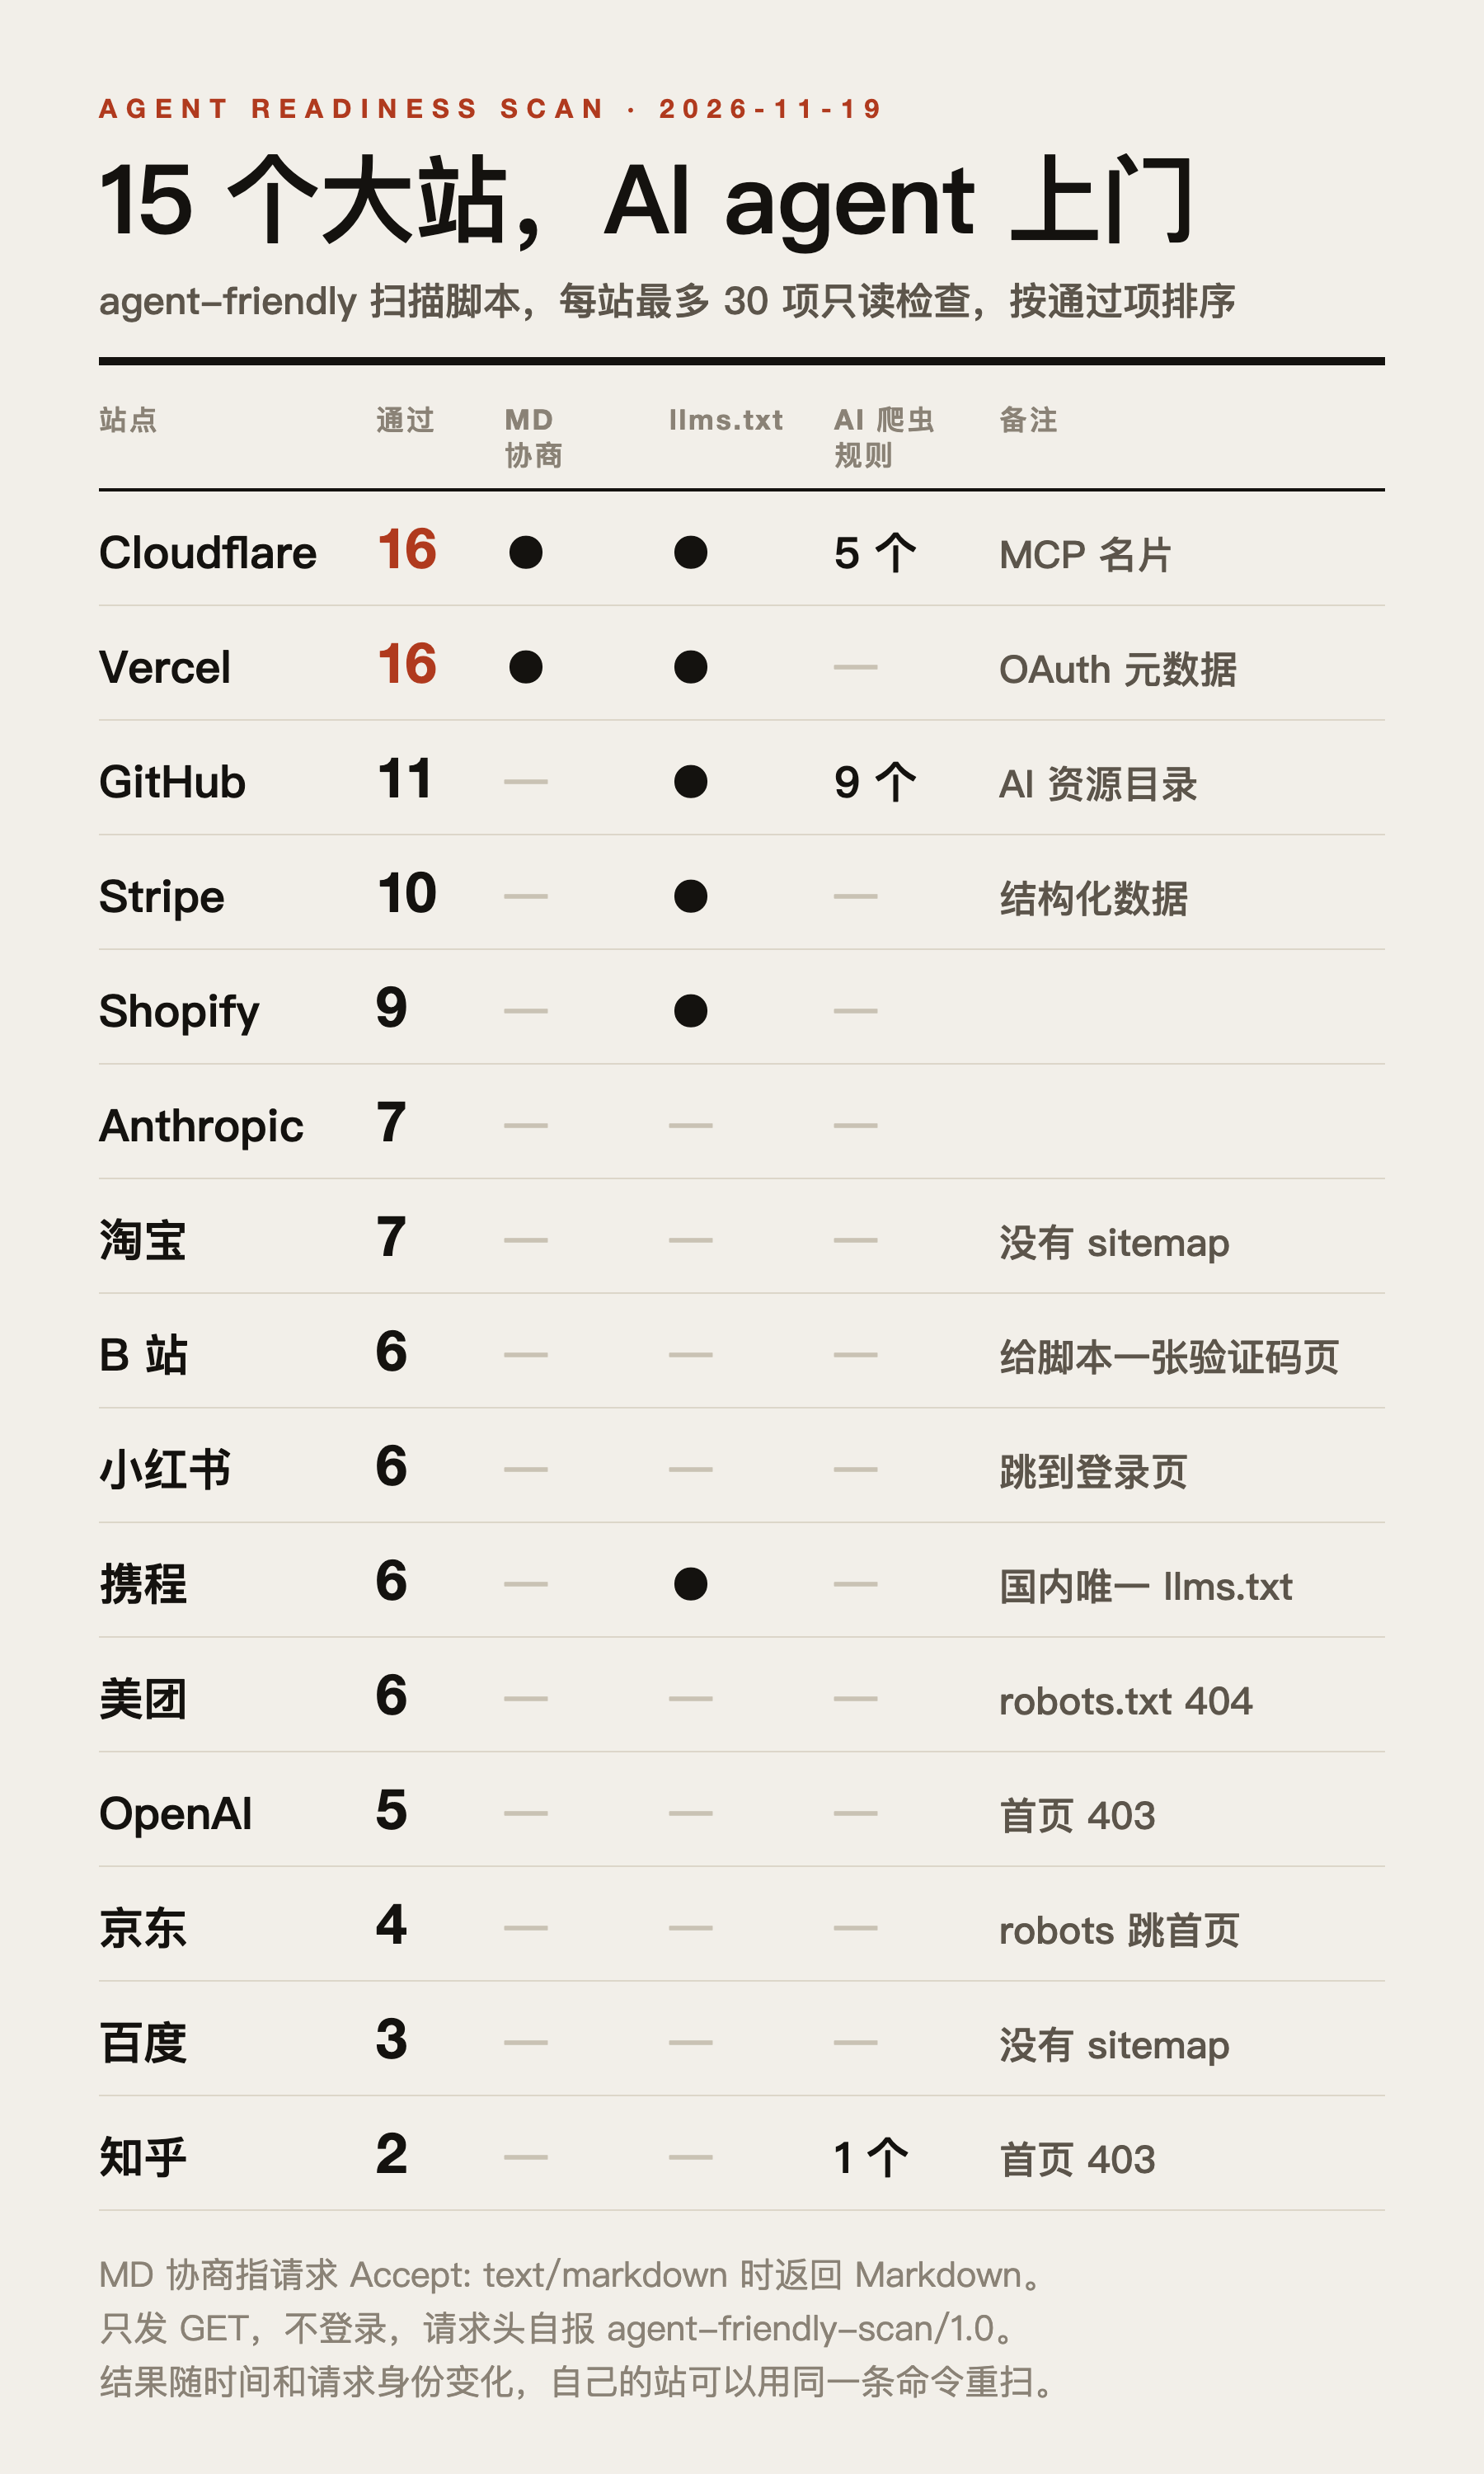
B 站给 AI 的是一张验证码页
扫描脚本很老实,请求头里报了自己的名字,只读不写,也不登录。
B 站回给它的,是一张 1 KB 出头的验证码页,能读出来的只有约 8 个字符。
我换成 Chrome 浏览器的身份再要一次,拿到 150 多 KB 的正常首页,约 670 个字符。
同一个网址,看人下菜。
小红书把脚本直接带去了登录页。OpenAI 和知乎更干脆,回了 403,不让进。
挡爬虫是网站的正当选择,这点没什么可说的。可往后上门的程序,越来越多是替真人办事的 AI。它被挡在门外,用户就只能自己动手。
只有两家把 Markdown 递到 AI 手上
每个站最多查 30 项,过得最多的是 Cloudflare 和 Vercel,各 16 项。
它们做到了一件别家都没做的事。AI 在请求里说一声「我要 Markdown」,网站就直接给一份干净的文字版,AI 不用再从一堆网页代码里抠正文,省下大量 token。
15 个站里,只有这两家做到了。
还有一份叫 llms.txt 的文件,是写给大模型的网站导读。15 个站里 6 家发布了,国内 8 个站里只有携程有。
robots.txt 是网站跟爬虫打招呼的地方。GitHub 给 9 个 AI 爬虫分别写了规则,Cloudflare 写了 5 个,知乎只写了 1 个。京东和美团,按首页域名去找这份文件,都找不到。
这些事,花一个下午就能做完。
这个工具背后有一张标准地图
我做 agent-friendly,是因为我一直觉得,软件和系统对 AI 友好,会是接下来几年的一件大事。
动手查资料才发现,相关标准已经出了一大堆,MCP、A2A、llms.txt、OpenAPI,还有鸿蒙的意图框架,可我没找到一份东西,能告诉你一个现成的系统从哪改起、改到什么程度算完。
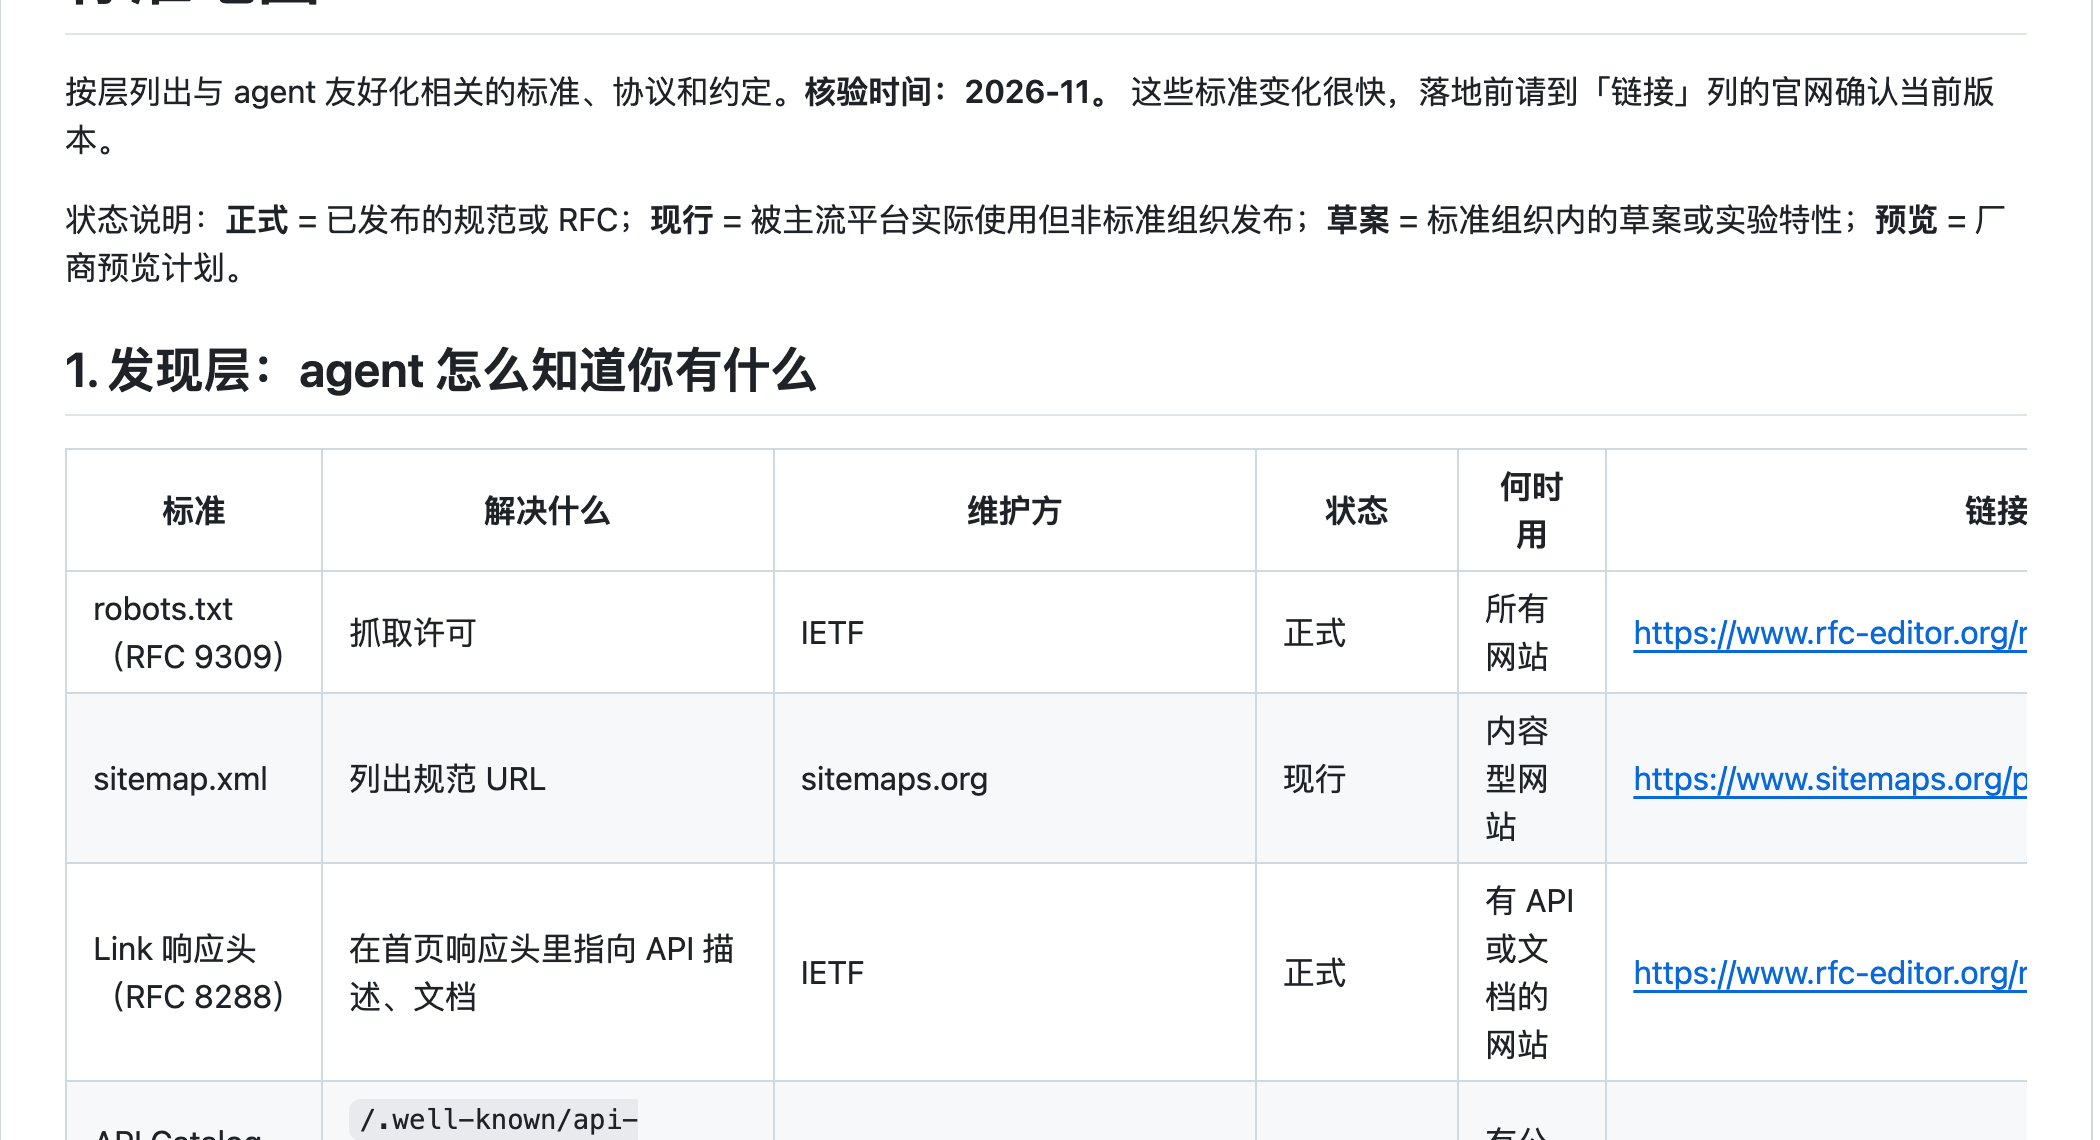
所以我先理了一张标准地图,8 层 53 项。
每一项都附官方链接,前四层还标了维护方和状态(正式、现行、草案、预览),核验到 2026 年 11 月。
维护方有 IETF(引用了 10 份 RFC)、W3C、Linux 基金会、OpenAPI Initiative、OWASP、美国 NIST,还有 Apple、Google、华为。
国内对照了 GB/Z 185 智能体互联系列国标、工信厅 2026 年 42 号文,以及正在制定的《智能体应用安全基本要求》。欧盟对照了《人工智能法》第 50 条。
每条改造建议都能落到一份查得到的规范上,你不用信我的转述。
扫描只是第一步
agent-friendly 是一个 Agent Skill,装进 Cursor、Claude Code、Codex 以后,AI 会带着你按十个阶段,把一个系统改到 AI 能替用户办事。
有三条规矩我最想让大家看到。
付款、删除、对外发消息这类不可逆的操作,没有系统级的人工确认,也没有带额度的预授权,就不开放给 AI。
验收要看 AI 能不能连续成功。单次成功率 90% 的 AI,连续 8 次都成功的概率只有约 43%。
项目定了 8 条红线,碰到一条就一票否决。项目里的餐厅订座示例,各项分数都够了,可用户看不到 AI 以他的名义做过什么,等级直接封顶,验收不通过。
一条命令,扫扫你自己的站
python3 scripts/scan_site.py https://你的网站 --doh https://dns.alidns.com/resolve国内网络加上后面的 --doh,换成阿里的 DNS 解析。脚本只用 Python 标准库,不用装依赖。
想装进 AI 编程工具,对它说一句「帮我安装这个 skill:https://github.com/chrislee121/agent-friendly」就行。
项目是 MIT 协议,开源免费。
标准变得太快,一个人盯不过来。地图里哪项过时了,你的行业还缺什么,或者扫描把你家网站判错了,都欢迎到 GitHub 提 issue,一起把它补全。
项目地址:https://github.com/chrislee121/agent-friendly
你觉得,以后你会让 AI 替你上网办事吗?评论区聊聊。