我把 文脉 Wenmai 开源了。仓库在 GitHub:https://github.com/chrislee121/wenmai ,版本 v0.1.0。
DeepSeek Harness 上已经能装好几款 llmwiki。Hermes 里也有 LLM Wiki。那些插件把本地 Markdown 当成 Agent 的长期记忆,上一轮聊过什么,下一轮还能搜回来。
我更烦另一件事。公众号、视频脚本、文案、课程讲义各攒一堆,过三个月我会问自己,这个选题写过没有。脚本里用过的例子,文章里又写了一遍,口径还对不上。
我按 Karpathy 那套 LLM Wiki 来做。原文进 raw/ 之后不再改,Agent 再编译成互相链接的概念页。它跑在 DeepSeek Harness 上,不依赖 Hermes,也不上向量库。闲聊默认不进库。本地就是一套 Markdown 目录,Obsidian 能直接打开。
用法我先放这儿,装完就按这三步转。
一、选题防撞
文字工作越做越多,自己跟自己撞车的次数也会变多。网上资料反而还好搜。
同一个产品你写过评测,又写过脚本,再写课程时已经忘了自己站过哪边。评论区有人翻旧文,你才想起来口径改过。
我给它做的杀手功能是 **wenmai_written**。你把选题名丢给 Agent,它同时查编译页和工作区里的文件名、标题。不要凭记忆回答「写过没有」,我在插件的系统提示词里也写死了这一条。
我把自己的文稿目录接进去,关联图一次画出两百多个节点。目录是簇,文章铺在目录框里。放大之后文件名才出来,不用在缩略标题里猜。
二、和现有 llmwiki 差在哪
社区里的 llmwiki 我对照过 EveGoodEvening 和 chancelu 两套 DeepSeek Harness 插件。一套盯证据链,源 ID 必须真实存在。一套盯会话记忆,可以自动把每一轮对话记进日记。
我不跟它们抢「Agent 记不记得」。成稿要你自己 ingest(把原文收进库),不从闲聊里自动抓。目录是人能读的 entities/、concepts/,不是一串哈希文件夹。开局只注入 SCHEMA、目录和最近日志,不做每轮 RAG。
| 文脉 Wenmai | 常见 llmwiki | |
|---|---|---|
| 用户 | 写文章、脚本、文案、文档的人 | 要给 Agent 加记忆的人 |
| 核心问题 | 这个选题写过没有 | 上一轮聊过什么、这条结论从哪来 |
| 写入 | 主动 ingest 成稿 | 证据源或自动捕获对话 |
| 开局 | SCHEMA + index + log 尾 | 检索注入或证据链 |
表后只剩一件事。你要是做 Agent 记忆,用现成 llmwiki 更合适。你要是做选题防撞和成稿编译,再装我这个。
ingest 之后,raw/ 里的原文就锁住,纠错写在编译页上。wenmai_write 会拒绝写进 raw/。lint 只报告断链、缺文件头、哈希漂移,不自动改。
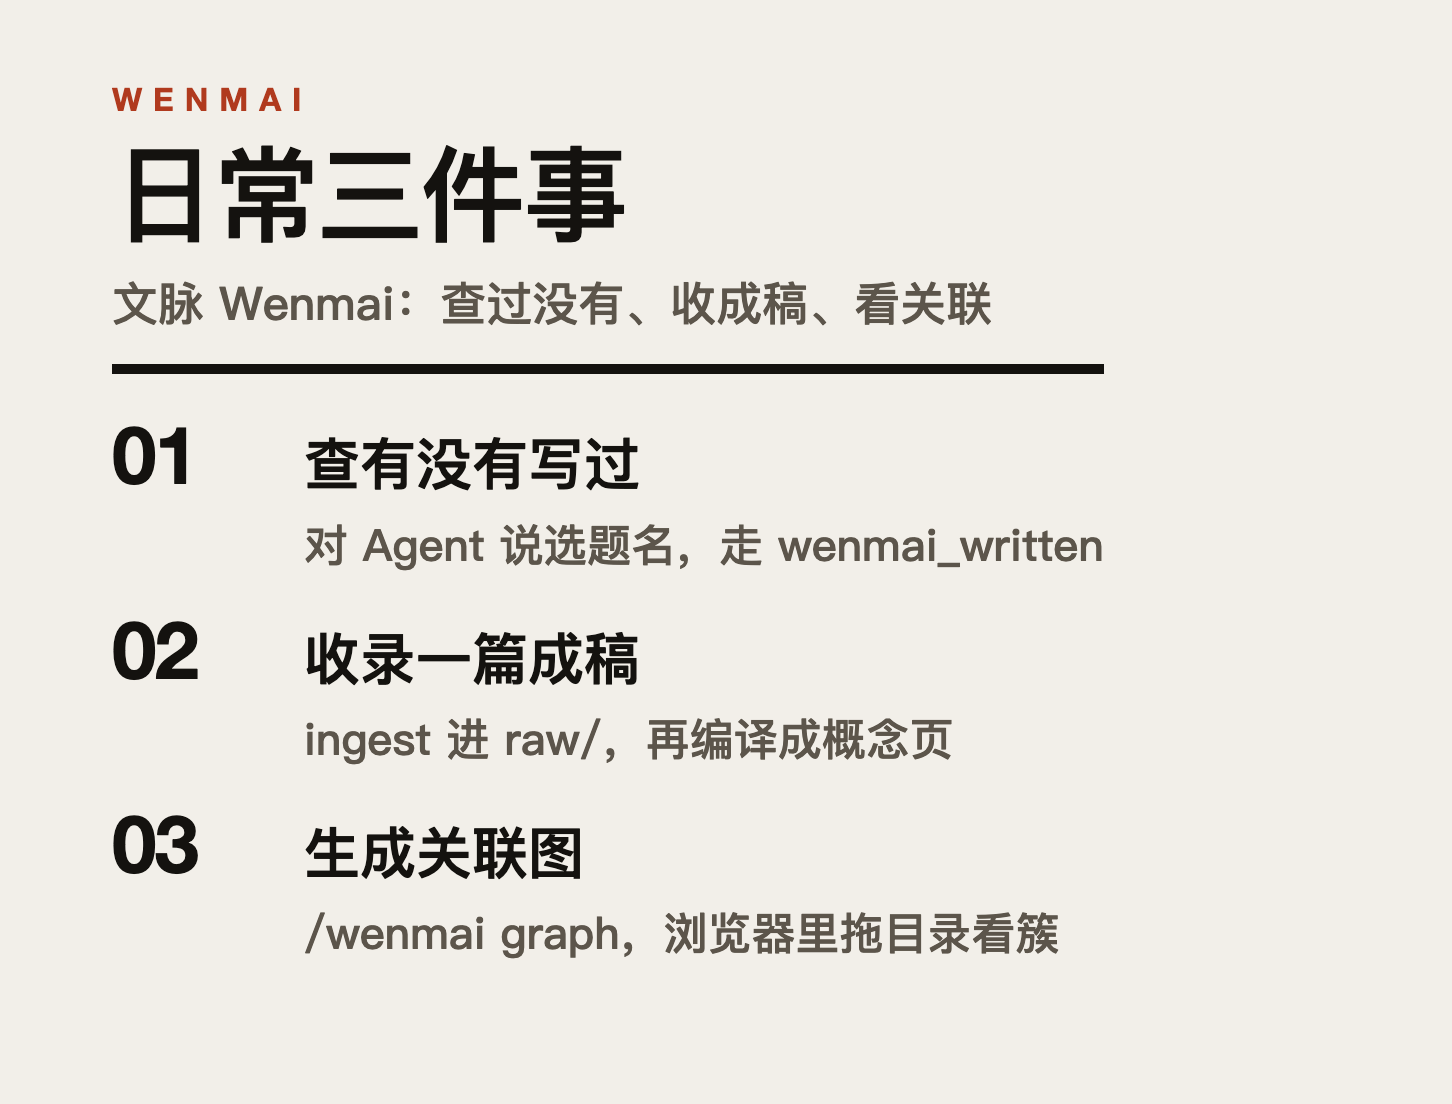
三、日常三件事
装好插件、在 Web UI 左上角选中你的文稿文件夹,就可以开始。未选工作区时输入框是灰的,这是 DeepSeek Harness 自己的限制。
1、查有没有写过
直接说下面这句。
用 wenmai_written 查一下「某某选题」我写过没有
有命中再让它读对应概念页。没有命中,再决定写不写新的。
2、收录一篇成稿
把本地 Markdown 路径丢给 Agent,让它 ingest,再编译成概念页。ingest 只复制到 raw/,编译是下一步 wenmai_write。新页要带 YAML 文件头,至少两个 [[wikilinks]],并更新 index.md 和 log.md。
材料类型用 kind 分进子目录。articles 放文章,scripts 放口播和分镜,docs 放 SOP 和讲义,transcripts 放转写,papers 放长研究,workspace 放草稿。
它不负责抓网页,也不负责解析 PDF。你先有正文,再 ingest。
3、生成关联图
输入 /wenmai graph,会在 ~/wenmai/graph.html 写出一张自包含的图。浏览器里可切换力导向和目录簇。局部图可以指定某一页做中心。
不要每轮对话都生成。需要看的时候再跑。
斜杠命令还有 /wenmai status、/wenmai lint、/wenmai orient。复杂读写仍走对话里的工具。工具一共十个,日常高频是 written、ingest、search、read、write、graph。完整参数表我写在仓库 README 里。
四、现在怎么装
需要 Node.js 22.19 或 24。本机已有 dsh,就跑这几行。
git clone https://github.com/chrislee121/wenmai.git
dsh plugin --profile web add /你的路径/wenmai
dsh --profile web --dump-config
dsh web
没有 CLI 就用 npx --yes @deepseek-ai/dsh@0.1.0-rc.8 走同一套 plugin add。dump-config 里应出现 dsh-wenmai 和 id: wenmai。浏览器打开 http://127.0.0.1:3080 ,对新库说一句「用 wenmai_init 初始化文脉」,领域写成你自己的文字工作即可。
默认数据目录是 ~/wenmai。卸载插件不会删库。不要把家目录整盘配进扫描路径,默认只扫当前工作区。
之前写过 DeepSeek Harness 本地 Web UI 怎么打开。网页能聊之后,把文稿目录选成工作区,文脉才能查得到你写过的东西。
现在这套只挂在 DeepSeek Harness 上,下一步我想做 本地客户端,同一份 Markdown 文脉,Cursor、Claude Code、Codex 和其他 Agent 都能接,想用的话评论区留一句。
参考链接
- 文脉 Wenmai 仓库:https://github.com/chrislee121/wenmai
- DeepSeek Harness:https://github.com/deepseek-ai/deepseek-harness
- Karpathy — LLM Wiki:https://gist.github.com/karpathy/442a6bf555914893e9891c11519de94f
- EveGoodEvening dsh-llmwiki:https://github.com/EveGoodEvening/dsh-llmwiki
- chancelu dsh-llmwiki:https://github.com/chancelu/dsh-llmwiki