多数人第一次搭多步 Agent,画出的都是一条直线。
第一步,第二步,第三步。每一步都礼貌等上一步做完,再开工。
用久了你会发现:十次里有九次,一半步骤根本不用等。
它们不分支,不路由,不并行。只是排队。一个脑袋,一份上下文,一次干一件事。直到窗口塞满,Agent 忘了自己在干什么。
上次那篇《一文读懂 Graph Engineering》讲清了:Loop Engineering 为什么不够、Graph Engineering 修了什么、锚点为什么拓扑买不到。
这篇接着动手:在 Claude Code 动态工作流里,怎么把 Graph Engineering 落到节点、边、扇出和验证器。
节点负责想,边负责传结果,协调本身尽量交给代码,不烧模型 token。
一、先问:你该不该上「图画法」
官方把差异说得很清楚:普通 subagent / Skill / Agent teams,计划还在 Claude 脑子里,中间结果挤进上下文。动态工作流把计划写进 JavaScript 脚本,中间结果留在变量里,主会话只收回最终答案。
再记四个层级,别混:
-
Prompt 是一句话
-
Loop 是一个循环
-
Harness 是 Agent 站的地板(工具、权限、运行时)
-
图(Graph) 才是工作本身的形状:谁先谁后、谁能同时跑、谁必须等齐
Claude Code 已经把画图的工具备好了:你描述目标,Claude 写编排脚本,运行时在后台拉起协调过的子 Agent 舰队。
那你今天要练的,不是「多问一句」,是 看见节点和边。
二、14 步总表(收藏向)
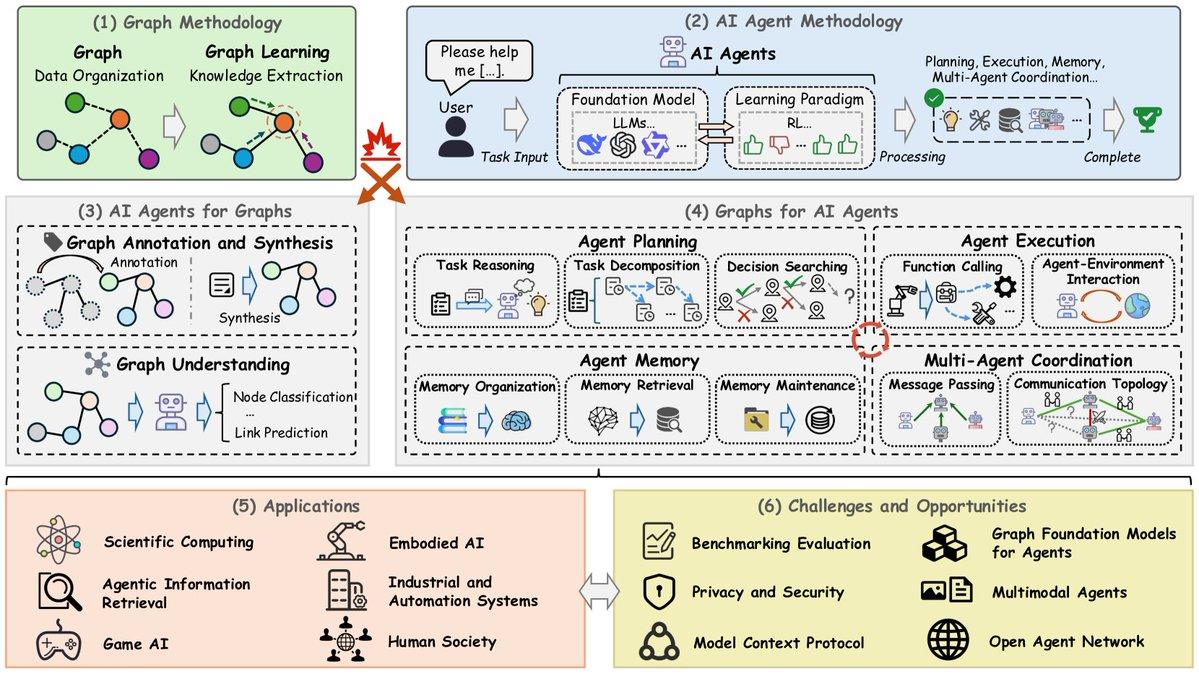
按「从看见图 → 能扇出 → 能自检 → 能自画」排:
表看完记一句:前 4 步是眼力,5–11 是肌肉,12–14 是成本和自动化。
下面逐步拆。每步都带「适用」和「翻车」。
三、01–04:先把图画对,再谈快
1、节点是活,边是流
图里只有两样东西。
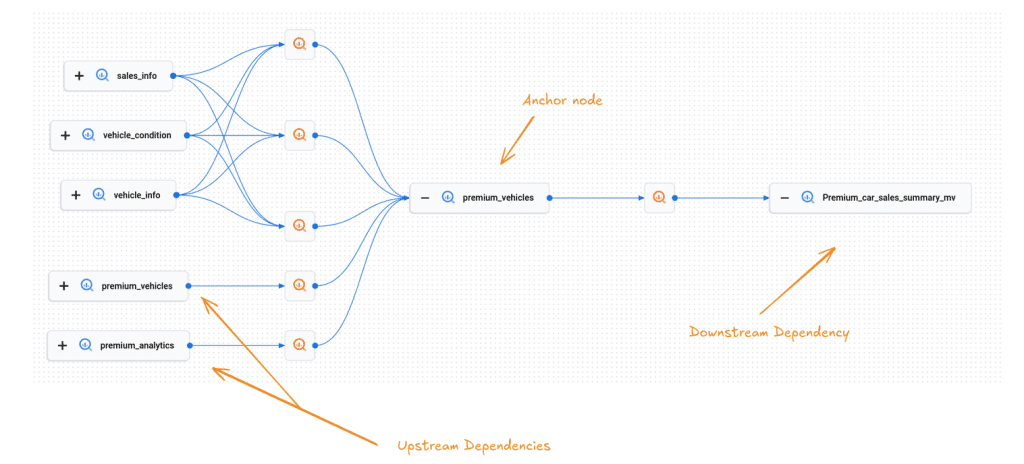
节点:一份有界的活。一个 Agent,一个输入,一个输出。 边:依赖。说的是「这个节点的输出,喂给那个节点的输入」。没有别的意思。
最大的坑,是把「然后」当成边。
「先总结这个文件,然后告诉我天气」——天气并不消费总结。这是两个不相连的节点,被线性脚本硬串起来。边只在数据真的跨过去时才存在。
对每一个「然后」问一句:下一步会不会读上一步的输出?不会,就没有边,等就是浪费。
画成方框和箭头。方框是一次 agent()。箭头是某个返回值进了下一个 prompt。画不出箭头,两个框就是独立的——后面所有加速,都靠这点独立性。
翻车:为了「流程好看」硬串无关步骤,图看起来很专业,实际全是假边。
2、你的线性脚本,是退化的图
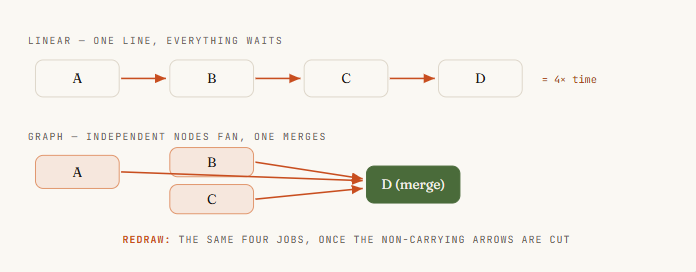
「做 A,再 B,再 C,再 D」——这也是图。只不过是一条不分支的链。每个节点恰好一边进、一边出。
它能跑。但慢,也脆:C 卡住,D 永远不来,A 的结果堵在上游。
图工程的第一项真本事:重画这条链。对每条箭头问第 1 步那句。多数链里有两三条箭头不传数据,只是你打字的顺序。剪掉它们,链会变宽:几个可并行的独立节点,喂给一个真正需要全集的汇聚节点。
翻车:以为「能跑通」就等于「图画对了」。能跑通的直线,往往是最贵的形状。
3、给每个节点一份合同
你讲不清的节点,就并行不了。
合同三件套:有界输入、有界输出、只干一件事。输入显式传入,别指望共享窗口里「大家都知道」。输出最好是固定形状,最好可校验,下游才能不用猜。
在动态工作流里,合同靠 JSON Schema 落地。给 agent() 挂上 schema,子 Agent 必须回校验过的结构化数据;校验在工具层做,不匹配会重试,而不是丢给你一段自由文本再祈祷能 parse。
const ITEM = {
  type: 'object', additionalProperties: false,
  properties: {
    title:  { type: 'string' },
    url:    { type: 'string' },
    impact: { type: 'string', enum: ['high', 'medium', 'low'] },
  },
  required: ['title', 'url', 'impact'],
};

const result = await agent(source.prompt, {
  label: `research:${source.key}`,
  schema: ITEM,
});
这才是「能焊进图」的节点,不是「只有人读得懂」的节点。
翻车:节点输出散文,下游用正则抠字段。图一变大,全崩。
4、把边当成数据合同
边不只是「B 在 A 后面」。它是一份承诺:A 产出这种形状,B 按这种形状消费。用数据命名边,而不是用顺序命名,两件事立刻变容易:
-
一眼看出边是不是真的(有没有数据在流)
-
两端节点可替换,只要形状不变
实践里,扇出和综合之间的 reduce——flatten、去重、过滤——就是普通 JavaScript。不需要 Agent。
这是图思维里最安静的红利:很多人烧掉的模型 token,其实只是在付「边」的租金。边本来可以免费。
想开一个 Agent「帮我合并结果」?先忍住。若合并等于 flatten + dedupe,那就是 flatMap 加一个 Set——确定、瞬间、零 token。Agent 留给判断,不留给管道。
翻车:每条边上再塞一个 Agent。图在付自己的接线费。
四、05–07:扇出、扇入、钻石
先把两个词说人话。别被英文术语吓住。
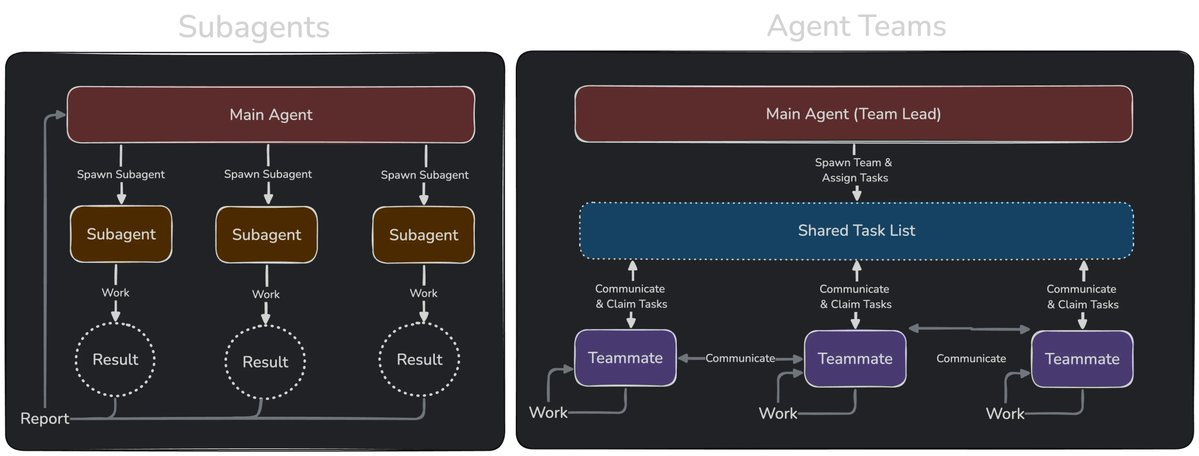
扇出(fan-out):一活拆成多份,同时派出去干。像从一点张开一把扇子——九个源、九个文件、九条路由,一起跑,谁也不等谁。对应代码里就是 parallel()。
扇入(fan-in):多份结果收回来,汇到一个点上再往下。扇子合拢——跨源去重、按影响排序、写综合报告,这些事必须看到全集才做。
中间那道「等齐才往下」的墙,叫屏障。扇出不等于立刻扇入:只有真需要全集时,才值得付这笔等待。只是把列表拍平、过滤掉空值,那是边上的小事,别当成扇入。
记一句:扇出换广度,扇入换齐活。 下面三步,就是围着这两件事练。
5、用 parallel() 扇出
这是把账赚回来的那一招。
N 个独立节点——N 个源、N 个文件、N 条路由——别串。让 Claude 扇出去,一起跑。parallel() 吃一组 thunk,每个 thunk 起一个子 Agent,并发执行,再把结果数组还你。
两个细节让它稳:
-
parallel()是屏障:等齐才返回,下一阶段看到的是全集 -
某个 thunk 抛错会变成
null,不拖死整批。永远.filter(Boolean)
并发大概卡在核心数附近,多出来的排队。你可以丢一百个 thunk,它们会跑完,只是一批一批来。
phase('Research');

const raw = await parallel(
  SOURCES.map((s) => () =>
    agent(s.prompt, {
      label: `research:${s.key}`,
      phase: 'Research',
      schema: ITEM_SCHEMA,
    }),
  ),
);

const collected = raw.filter(Boolean);
扇出活在 Claude 写的代码里,不在模型对话里。主上下文不会一次塞进九个源——每个子 Agent 自己扛,最后只收回答案。编排层几乎不烧 token,因为它不是又一轮「Claude 在想」。
官方硬顶:同时大约最多 16 个 Agent(机器弱会更少);单次 run 总计最多 1000 个,防失控循环。
翻车:把其实有依赖的步骤也丢进 parallel(),结果对不齐还难查。
6、在屏障处扇入
扇出有用,前提是有人收。不然九个 Agent 各干各的,你手里只剩九份互不说话的草稿。
扇入,就是那个「收」的节点:一个 Agent(或一段代码)同时看到全部上游结果,做必须看全集的事——跨源去重、按影响排序、全集为空就早退。这是屏障唯一值得付墙钟时间的地方:大家齐了,才往下。
规则很狠:只有某阶段真的需要所有先验结果凑齐,才用屏障。跨源去重?屏障。只是 flatten 列表?那是边,内联做完,不算扇入。
嗅觉测试:如果你写了 parallel → transform → parallel,中间 transform 没有跨条目依赖,你本该用 pipeline(),根本不该设屏障。
翻车:为了「阶段感」处处 parallel()。阶段分开 ≠ 必须同步。把 flatten 也当成扇入,图会无故变慢。
7、钻石形:拆 → 干 → 合
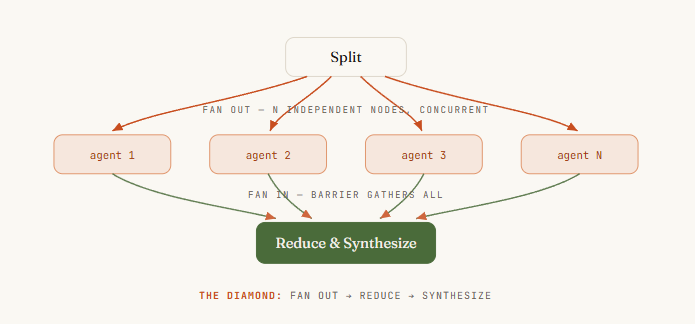
扇出加扇入,就是认真 Agent 图的主力拓扑:钻石。
一个节点拆活,多个节点并行干,一个节点合并。市场扫描、依赖审计、代码评审、调研报告——换源换 prompt,骨架不变。
记住标准三段:fan out → reduce → synthesize。扇出换广度,代码 reduce 压缩,最后 Agent 综合写答案。
一旦看见钻石,你就不再问「怎么让 Agent 多走几步」,而问「拆点在哪,合点在哪」——这才是能放大的问题。
翻车:没有 reduce,把九份原文直接塞进综合节点。综合节点变垃圾桶,又回到上下文爆炸。
五、08–11:路由、验证、隔离、循环
8、运行时按结果选边
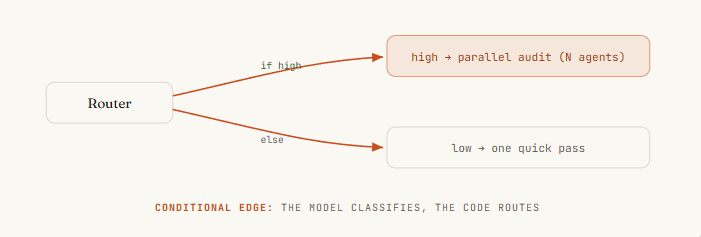
不是每张图都固定。有时走哪条边,取决于节点发现了什么。
路由节点看结果,再决定下游:给工单分类,再进对应 handler;看 diff 大小,小改快审,大改拉全量审计。工作流里这就是对校验输出写 if / switch——控制流在代码里。
确定性在这里是特性,不是限制。分类可以让子 Agent 做,路由由脚本执行:同一分类,路径每次一样。你得到节点上的判断力,边上的可靠性。不会出现「Claude 临时决定跳过审计」——除非你把跳过写进图。
const { severity } = await agent(
  `Classify this diff's risk:\n${diff}`,
  { schema: { type: 'object',
      properties: { severity: { enum: ['low', 'high'] } },
      required: ['severity'] } },
);

let review;
if (severity === 'high') {
  review = await parallel(FILES.map((f) => () => agent(`Audit ${f}`)));
} else {
  review = await agent(`Quick review of ${diff}`);
}翻车:路由也用自然语言「看着办」。图不可复现,出了问题没法复盘。
9、在边上挂验证器
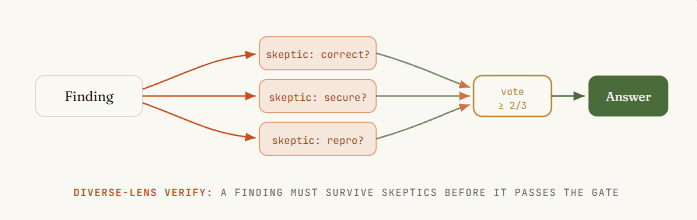
图的真杠杆不是「更多 Agent」,是你能包一层结构,换置信度。
验证器坐在结果下游放行之前,唯一工作是试图杀死这个发现。活下来的才过。死的到不了答案。
手里备三种:
-
对抗验证:每个发现拉 N 个独立怀疑者去反驳;多数活下来才留
-
视角多样验证:正确性 / 安全 / 能否复现——同质检查抓不到的坑,多样性能抓
-
评委团:多角度生成 N 个答案,并行打分,用赢家综合,并嫁接亚军亮点
这正是把严肃工程里「对抗式评审」嵌进循环的形状。官方内置的 /deep-research,骨架就是:扇出检索 → 拉取 → 投票验证 → 综合。
翻车:验证器和发现者共用同一 prompt、同一模型、同一偏见。那叫自嗨,不叫验证。
10、隔离节点,别让一个失败毒死全图
链里失败会 cascading:C 死,D 不跑,全停。图里失败应关在节点里。
parallel() 里 thunk 抛错变 null,八个好的还能回来。.filter(Boolean) 就是遏制。每个扇入都要能容忍缺输入,别默认全集到齐。
更隐蔽的失败:节点互相踩。并行写文件会撞。
修复是隔离:isolation: 'worktree'——每个 Agent 自己的 git worktree,沙箱里干活,再干净合并。只在节点真的并行写盘时用。它是安全带,不是每次 run 的默认税。
翻车:只读扫描也全开 worktree。又慢又贵,收益为零。
11、加循环,但必须收敛
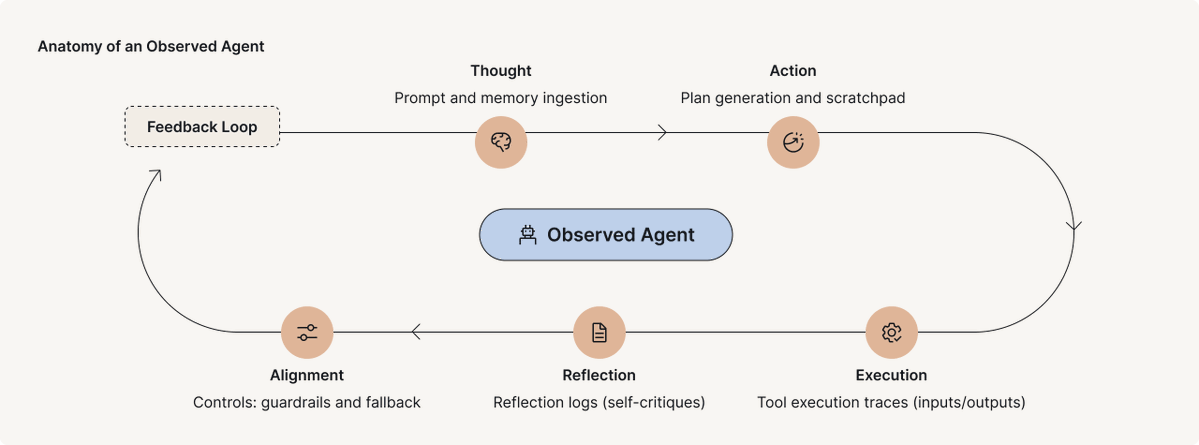
有时活有多大,进场前不知道:未知规模发现、修一个 bug 冒出三个。这就需要回到先前节点的边——循环。
危险很明显:不收敛的循环会一直生 Agent,直到预算烧光。
收敛模式叫 loop-until-dry:持续拉 finder,直到连续 K 轮没有任何新东西,再停。
几乎人人第一次都会踩的细节:对「见过的全部」去重,不是只对「已确认」去重。 否则被拒的发现每轮回来,永远干不了,机器会付费重访同一条死路。
const seen = new Set();
const confirmed = [];
let dry = 0;

while (dry < 2) {
  const found = (await parallel(
    FINDERS.map((f) => () => agent(f.prompt, { schema: BUGS }))
  )).filter(Boolean).flatMap((r) => r.bugs);

  const fresh = found.filter((b) => !seen.has(key(b)));
  if (!fresh.length) { dry++; continue; }
  dry = 0;
  fresh.forEach((b) => seen.add(key(b)));

  // 再挂多样验证……
}
官方 1000 Agent / run 的硬顶,就是防这种失控。
翻车:只对 confirmed 去重。循环永不干燥。
六、12–14:成本、拓扑、让 Claude 自画
12、跨节点分层模型
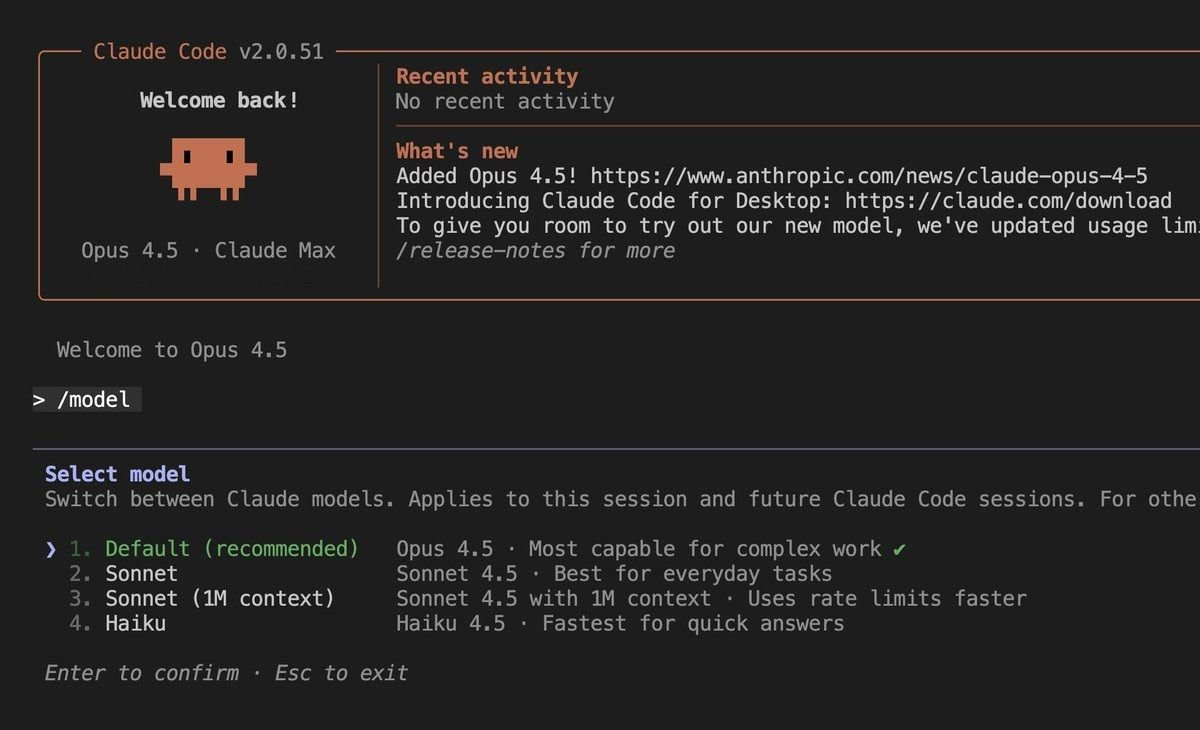
不是每个节点都需要最强模型。
图会把这件事摊开:有的节点有界又重复(抽字段、分票),有的承载真判断(写报告、裁定发现)。脏活走便宜模型,贵 token 留给判断。
工作流里,子 Agent 默认继承会话模型。单次 agent() 可指定 model,只改那个节点。大 run 前先看 /model,让扇出重复节点降档,合并节点留在高档。
形状不变,账单可以差一截。
翻车:全图一档旗舰。正确,但贵到不敢复跑。
13、拓扑就是成本和时延
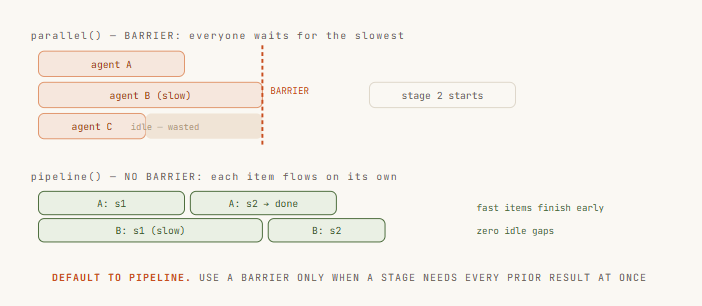
图的形状不是化妆。它是墙钟时间最大的杠杆。
最容易踩错的选择:parallel() vs pipeline()。
-
parallel():屏障。等最慢的那个,再开下一阶段 -
pipeline():每条 item 独立流过各阶段。A 可能已在阶段 3,B 还在阶段 1。快的先结束,不必在慢的后面干等
默认 pipeline()。 只有某阶段真需要全部先验结果齐活——跨集合去重、对总数早退、prompt 要对比「其他发现」——才上屏障。
「代码更干净」「阶段感觉分开」都不是理由。屏障延迟真实、可测、常被浪费。
翻车:全程 parallel() 当默认。图看起来很「工程」,跑起来像在等最慢的同学交卷。
14、让 Claude 画图:自路由
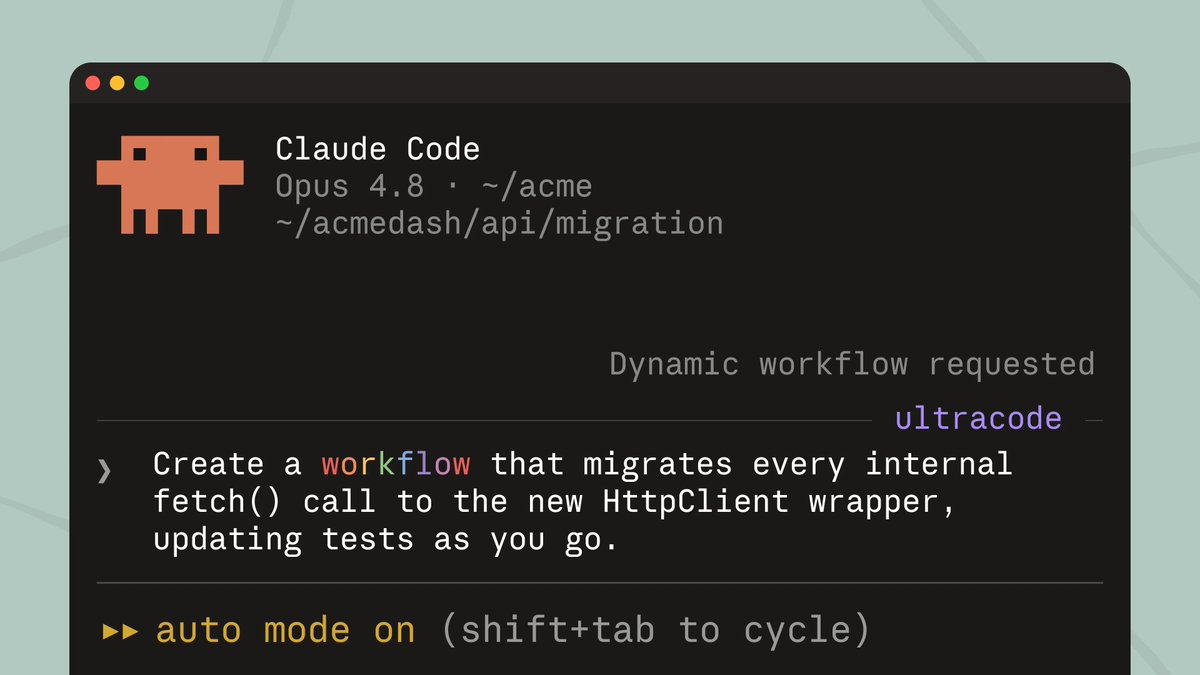
最后一招:对事先画不好的活,别再手动画固定图。
动态工作流下,你描述目标,Claude 自己写编排脚本——拆任务、选扇出、拉舰队、综合结果。你得到适配这一次的图,而不是「希望能套上」的固定图。
三条入口:
-
Prompt 里说「用 workflow / ultracode」——Claude 为这次任务写脚本
-
跑已有的:内置
/deep-research,或你保存过的 -
/effort ultracode——会话里实质性任务自动规划工作流(更费 token,用完记得降回)
跑得好,在 /workflows 里按 s 存进 .claude/workflows/(项目)或 ~/.claude/workflows/(个人)。版本可控,按名复跑,克隆仓库的人也能启动。
翻车:ultracode 开一整天日常改三行代码。大炮打蚊子,额度先空。
七、选型对照:什么形状配什么活
表后的人话:先问「数据有没有跨过去」,再问「要不要齐活」,最后才问「要不要验证」。顺序反了,图会又慢又假。
八、本周用 Claude 可建的 6 张图
原路线图给了六张可直接开干的图。对照官方能力,全部成立:
-
全路由安全扫描:每文件一个子 Agent 找缺鉴权,验证器过后再进报告
-
/deep-research带引用报告:内置图,拆角度 → 并行搜 → 去重 → 三票对抗验证 → 综合 -
按文件移植模块:扇出翻译,测试当门禁,失败回环;对抗评审拦住「单次会放行」的破洞
-
Diff 对抗评审:按 diff 大小路由;大改并行多镜头(正确性/安全/性能)+ 评委团
-
定时生态扫描:多源并行 → 屏障按影响排序 → 写 digest;存进 workflows 按名启动
-
未知规模发现:并行 finder → 对 seen 去重 → 验证存活者 → 连续两轮无新则停
最小启动姿势:
/deep-research 我们这个仓库鉴权中间件近一年改过什么?

# 或
ultracode: audit every route under src/routes/ for missing auth.
Spawn one agent per route file, verify each finding before reporting.先在一个小目录试跑。官方也建议:大任务先切片,/workflows 里随时停,已完成的不白费。
九、少许扩展:落到 Cursor / Codex 读者身上
原课停在「会画图的人跑舰队」。对本号读者,我补三句落地。
和 Cursor 的关系。 Cursor 强在编辑器里改代码、模型切换、规则。多 Agent 并行编排不是它的主战场。你要的是「几十个独立审计同时跑、编排可复现」,优先 Claude Code 动态工作流;Cursor 继续当你的主编辑器,不必为了「图」硬迁栈。
和 Codex / ChatGPT Desktop 的关系。 Codex 视图擅长编码 Agent 会话。若你的痛是「一次会话串很多步」,可以先用更清晰的分步;要「脚本级编排 + 可保存复跑」,目前更完整的故事仍在 Claude Code workflows。三件套可以并存:Claude Code 跑舰队,Cursor 改细节,Codex 补 OpenAI 栈任务。
什么时候别画图。 改三行、查一个报错、写一段说明——直线更快。图的税是:审批、token、调试拓扑的心智。原课说得对:线性 Agent 不是天花板,只是人人先摸到的第一形状。但反过来也对——不是每堵墙都要用舰队拆。
成本提醒(官方口径):单次工作流可明显贵过同任务对话;超过约 25 个 Agent 或预估超高 token 时,进度行会标 Large workflow(ultracode 会话可能不显示警告)。先小后大。
十、我的判断
会写 Prompt 的人在提问。会画图的人在编排。
线性 Agent 匹配我们打字的习惯:一行、一个头、一次一件事。一旦你能看见节点和边,你就不再逼单个 Agent「再多干点」,而是让图「干得更宽」:独立处扇出,置信处设闸,判断处留贵模型。
再泼一句冷水:AI 行业造词和造概念太快了。
Loop Engineering、Graph Engineering、动态工作流——半年换一拨。作者自己后来都后悔「graph」这个词偏粗,你不必每个新词都追着背,先让子弹飞一会。
真正值钱的,不是会不会念扇入扇出,而是你会不会问:有没有假依赖?该不该并行?谁验证谁?锚在哪?这几句问清楚了,叫什么工程都行。
参考链接
-
Claude Code — Dynamic Workflows 官方文档:https://code.claude.com/docs/en/workflows
-
Anthropic — Introducing dynamic workflows:https://claude.com/blog/introducing-dynamic-workflows-in-claude-code
-
Claude Code — Worktrees(并行写盘隔离):https://code.claude.com/docs/en/worktrees
-
原文脉络:Graph Engineering with Claude: 14-Step roadmap(社区课程/长文)