你做过 Agent 的都知道这堵墙:
一开始一个 Prompt、几个工具,Demo 能跑。需求一长,边界情况多了、团队多了、风险大了——突然变成 3000 字的系统提示词,想同时干五件事。
解法不是再加 Prompt,而是选对设计模式。
这篇我们不写「一文读懂 Agent 架构」。写我们关心的:生产级 Agent 系统几乎都从这 15 种模式里组合出来——每种什么时候用、什么时候该换、什么时候根本不该上 Agent。
之前写过《Loop Engineering》《Agent Harness 十二组件》《为什么Review成了2026最值钱的技能》——Harness 是零件,Loop 是调度,Review 是验证;这篇是架构层:你打算用哪种协作模式。
一、先判断:这任务该不该用 Agent?
不是每件事都要 Agent。
值得上 Agent 的信号:
-
单次模型调用拿不到可靠结果
-
运行时要在工具/数据源之间做选择
-
需要规划、验证或迭代精炼
-
流程里有真不确定性,没法全写死
通常不必上 Agent:
-
摘要、分类、简单抽取、模板化生成——输入输出路径固定
-
直接调模型更快、更便宜、更稳
-
硬包一层 Agent 只增加延迟和故障点,收益为零
我们见过太多团队把「单次调用就能搞定」的事套 ReAct,账单涨了,稳定性反而掉了。
二、15 种模式完整清单
下面按模式展开:适用条件 + 翻车信号(生产选型最值钱的部分)。
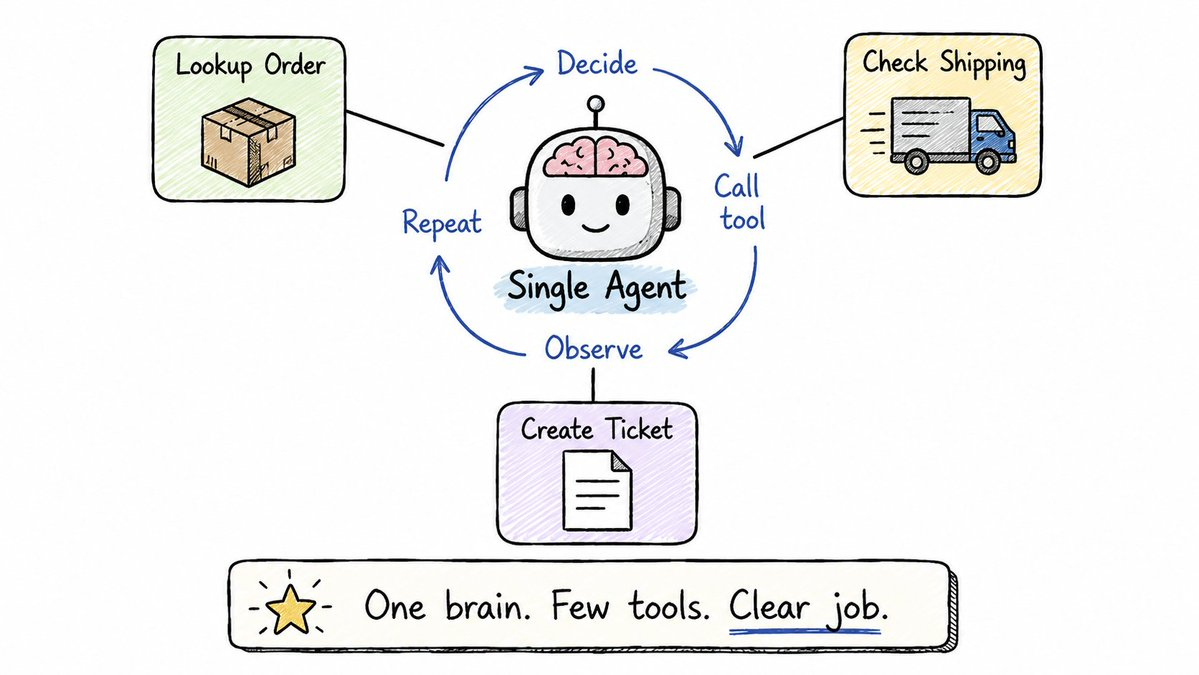
1、单 Agent
最常用起点。一个模型、一份系统提示、有界工具;模型选工具、看结果、循环直到能回答。
适用:任务边界清楚、工具少(2–3 个)、单 Agent 能撑住全上下文。
翻车:工具越加越多、系统提示词撑满一页——该换模式了,不是再加 Prompt。
Claude Code / Codex 默认形态往往就是单 Agent + 工具,先把这里榨干(见《Agent Harness 十二组件》)。
2、多 Agent 串行
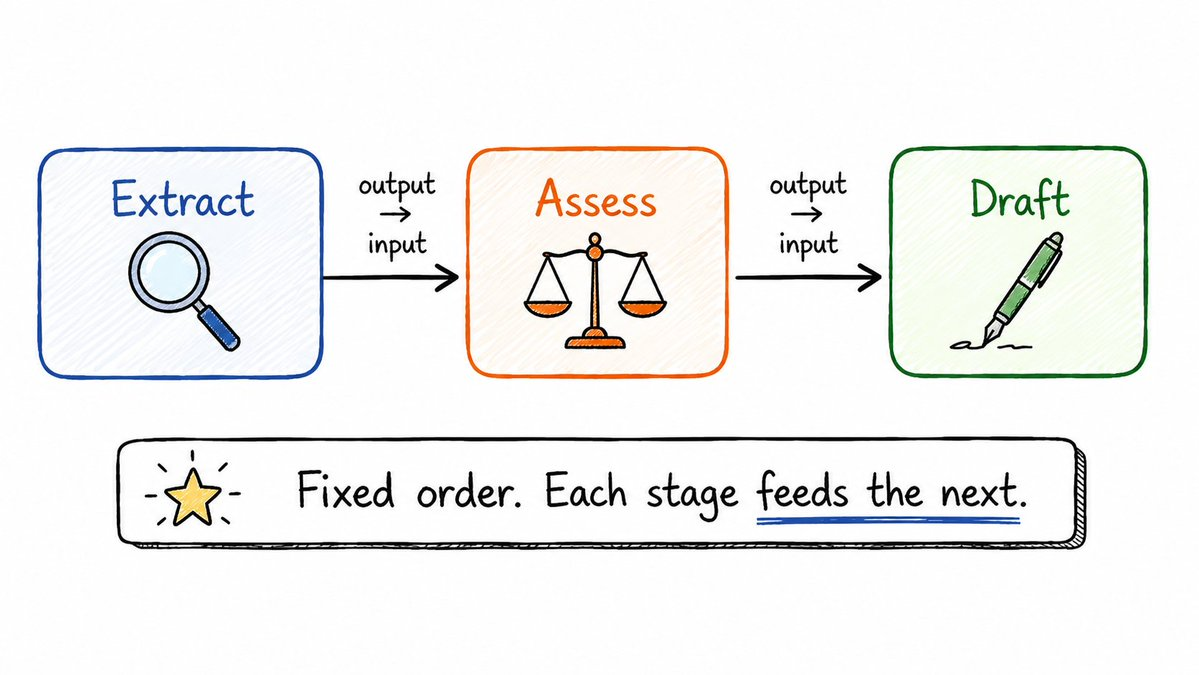
专家流水线,顺序固定。
适用:阶段清晰、可重复,每阶段产出正好是下一阶段输入。
翻车:中途发现路径该变——串行假设路径固定,动态分支要用更灵活的模式。
3、多 Agent 并行
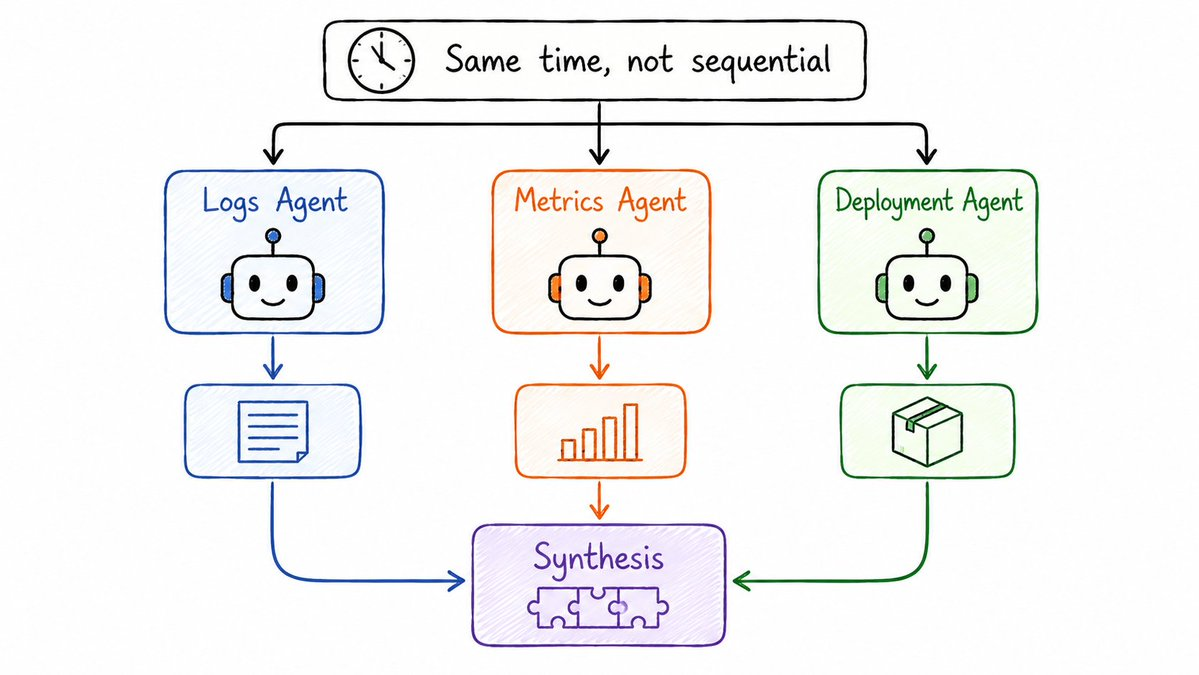
子任务互不依赖,同时跑,再汇总。
适用:真独立 + 要快(故障排查、多源检索)。
翻车:子任务其实互相依赖——硬并行会竞态、上下文残缺。
LangGraph / Codex sub-agent 并行时,先画依赖图。
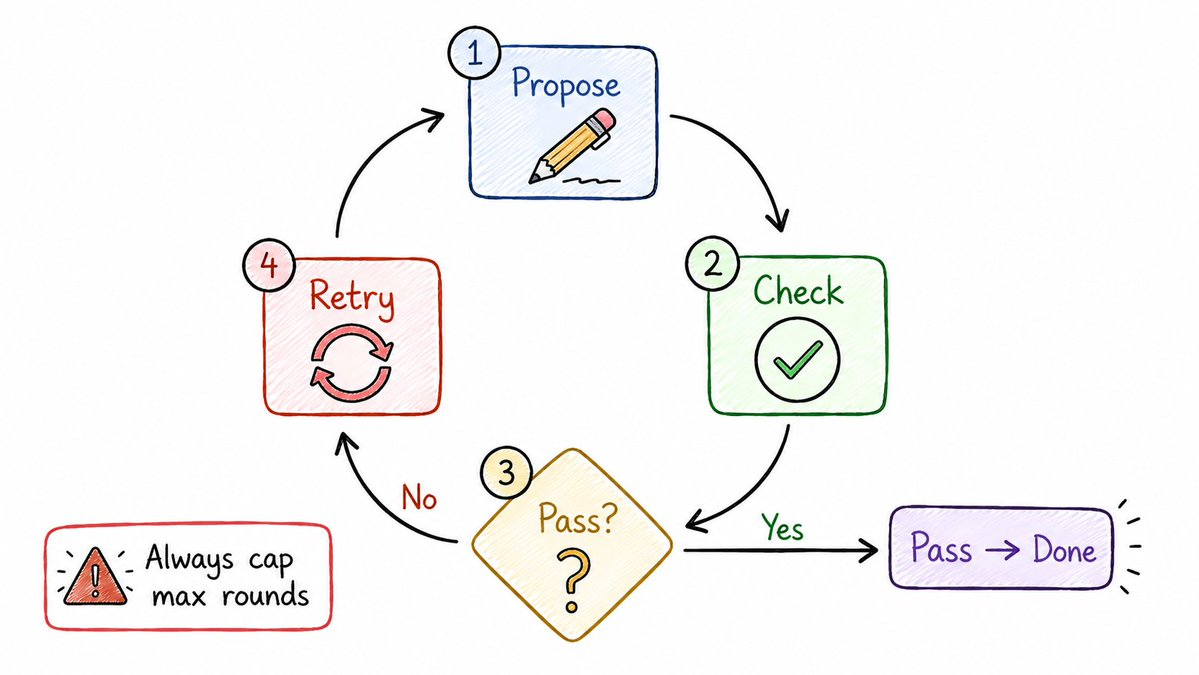
4、循环(Loop)
重复序列直到退出条件成立;务必带上限。
适用:可多轮尝试,且有可检查的停止条件(质检分数、测试通过)。
翻车:没有可靠退出条件 → 费用失控、永远跑不完。和《Loop Engineering》同一脉。
5、审查与批判
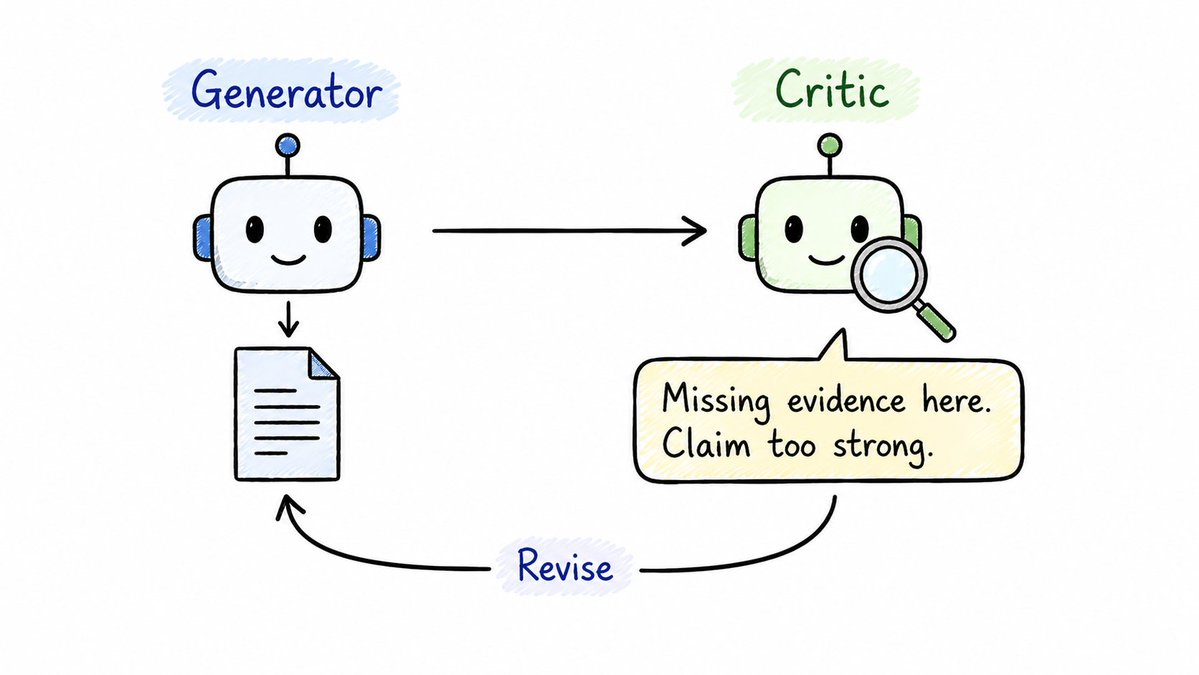
独立「裁判」Agent 审输出,给具体修改意见。
适用:质量优先于速度,要把第二意见写进系统,不是事后再补。
翻车:裁判和生成器同一套盲区——相似训练、相似假设,抓不到同类错误。要和《为什么Review成了2026最值钱的技能》一样:Review 方用不同指令/不同模型。
6、迭代精炼
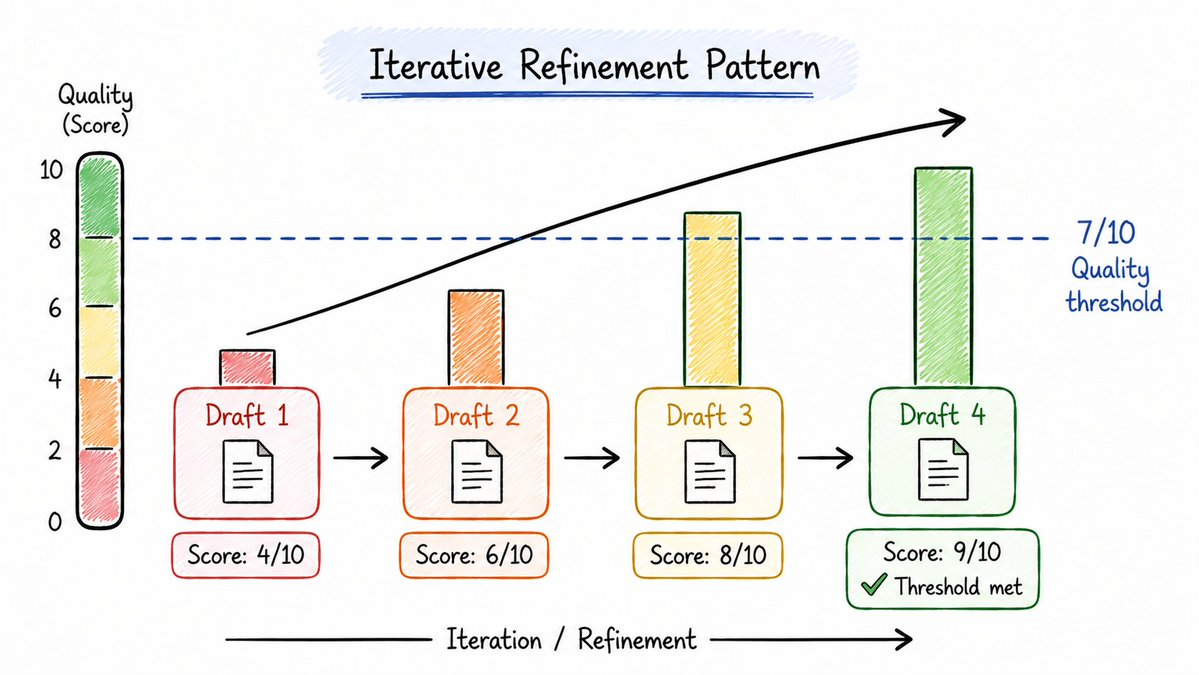
带质量分,未过阈值就继续改,是分级改进,不是一次过/不过。
适用:「够好」有可度量门槛(品牌分、可读性分)。
翻车:打分函数模糊或可刷分——模型自嗨提分,token 白烧。
7、协调器(路由)
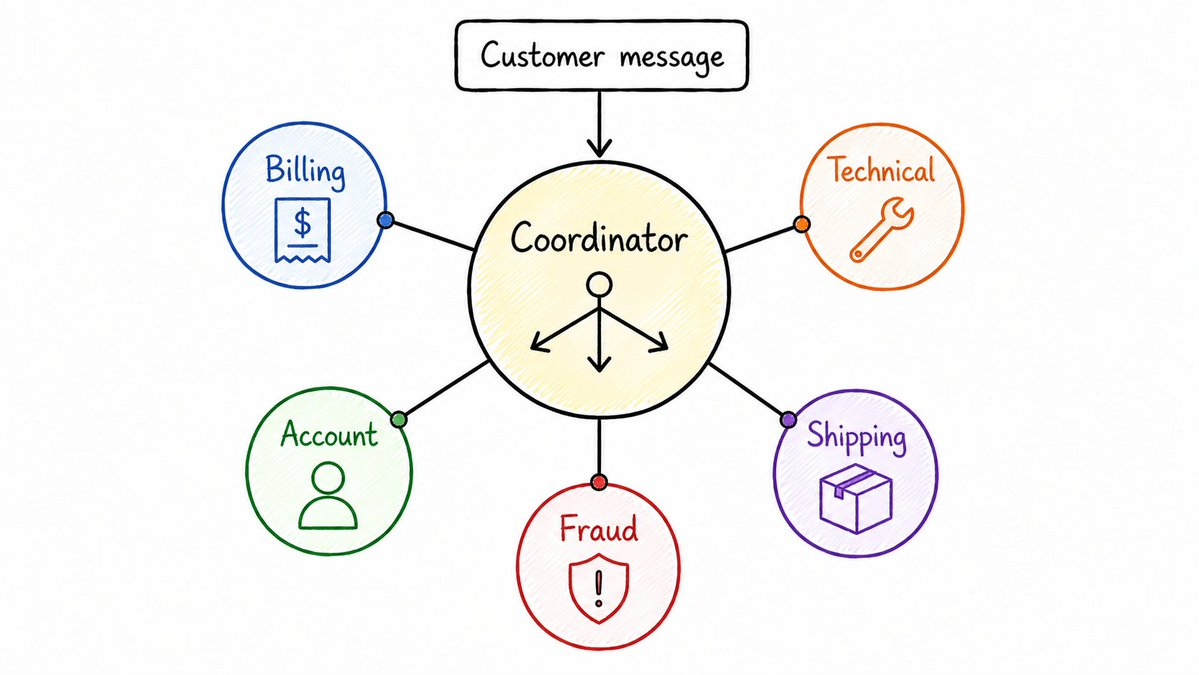
中央 Agent 按请求类型分发到专家。
适用:请求类型差异大,需要不同上下文、工具、决策逻辑。
翻车:请求本身难分类——协调器变成新瓶颈和误路由源。OpenAI 任务转交、Claude sub-agent 切换都属这类。
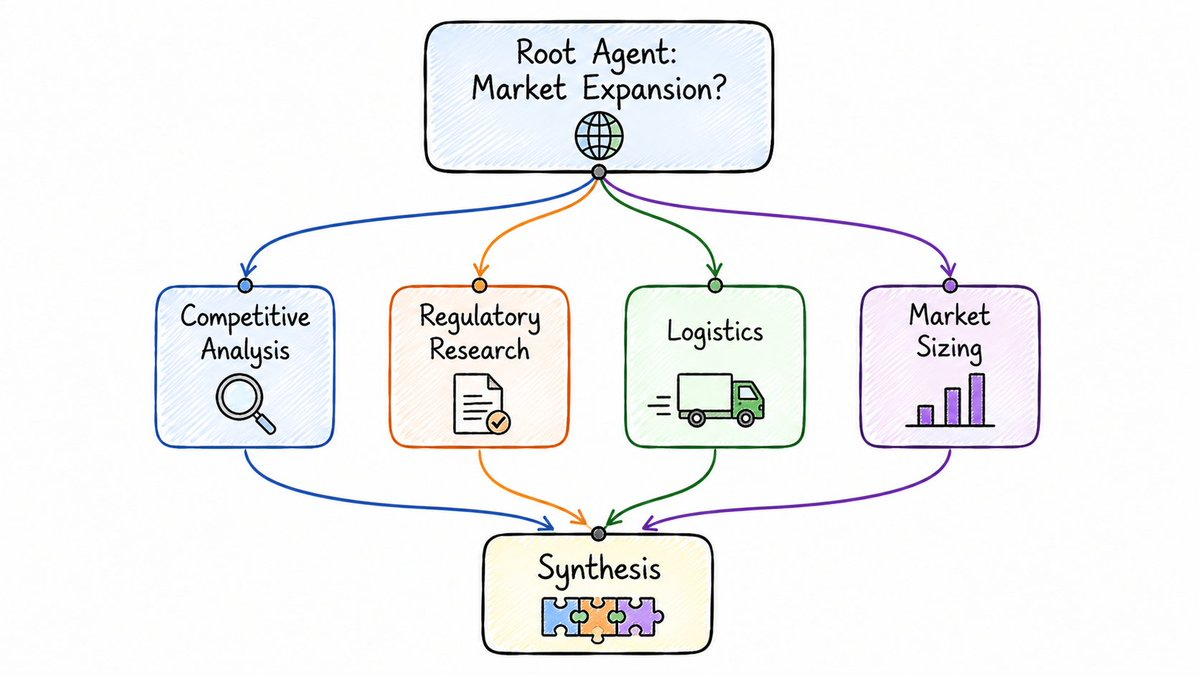
8、层级任务分解
根 Agent 拆子目标 → 派工人 → 合成答案。
适用:问题太宽,但能拆成相对独立的专业领域块。
翻车:子目标其实要实时互相影响——事先分解会丢交互。和蜂群的边界在这里。
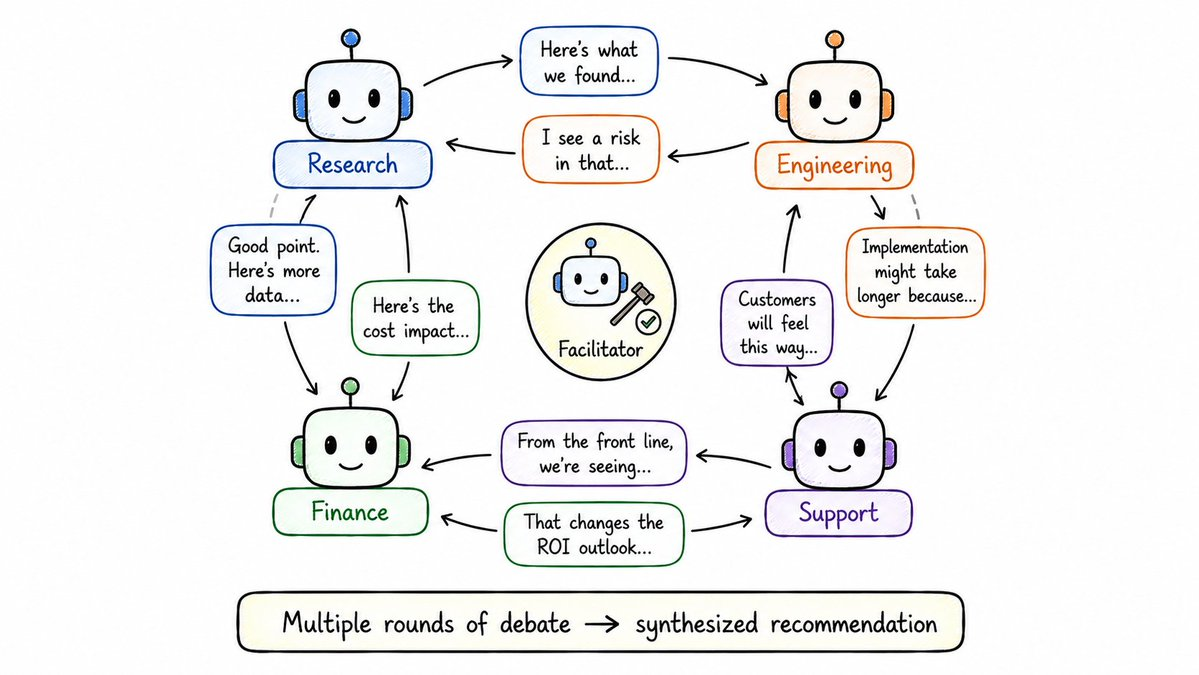
9、蜂群(Swarm)
多专家多轮讨论、互相质疑假设,由主持人出建议。
适用:没有唯一正确答案,需要多视角权衡(战略、定价、组织决策)。
翻车:要快速、确定性答案——蜂群故意慢、偏探索,不适合要秒回的场景。
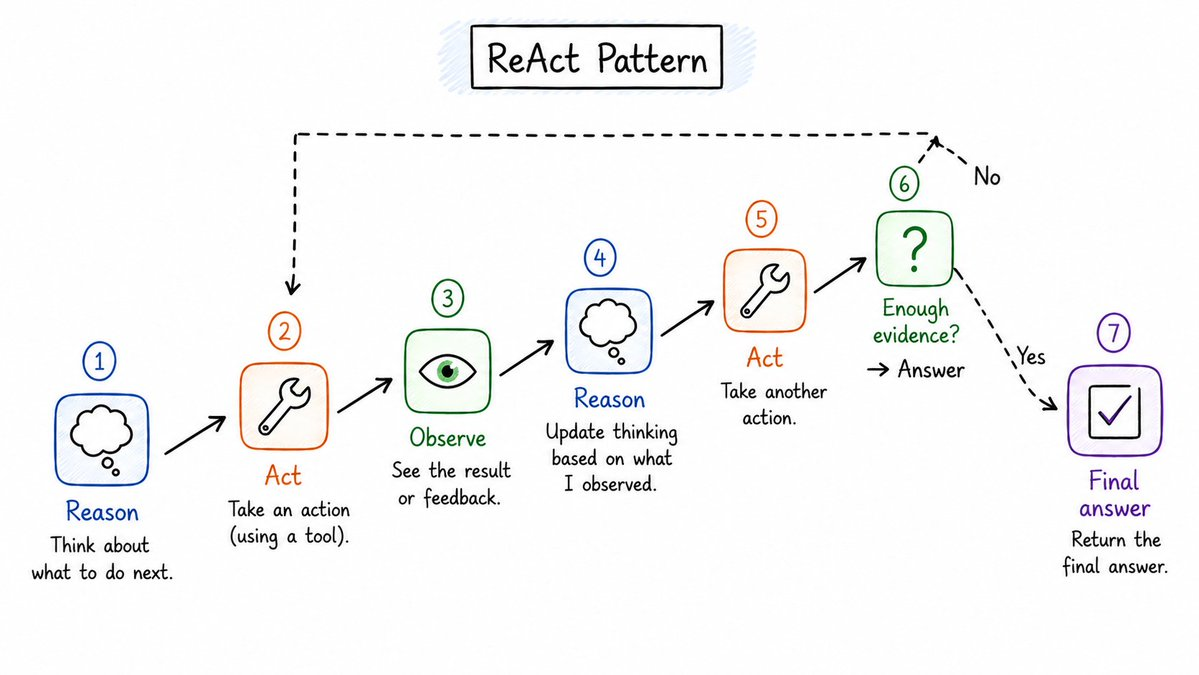
10、推理与行动(ReAct)
排查路径不能预先规划,靠每步发现决定下一步。
适用:「队列卡了」类开放排查;和单 Agent 的差别在路径是临场浮现的。
翻车:调查迟迟不收敛——必须给推理-行动轮次设上限,否则无限探索。
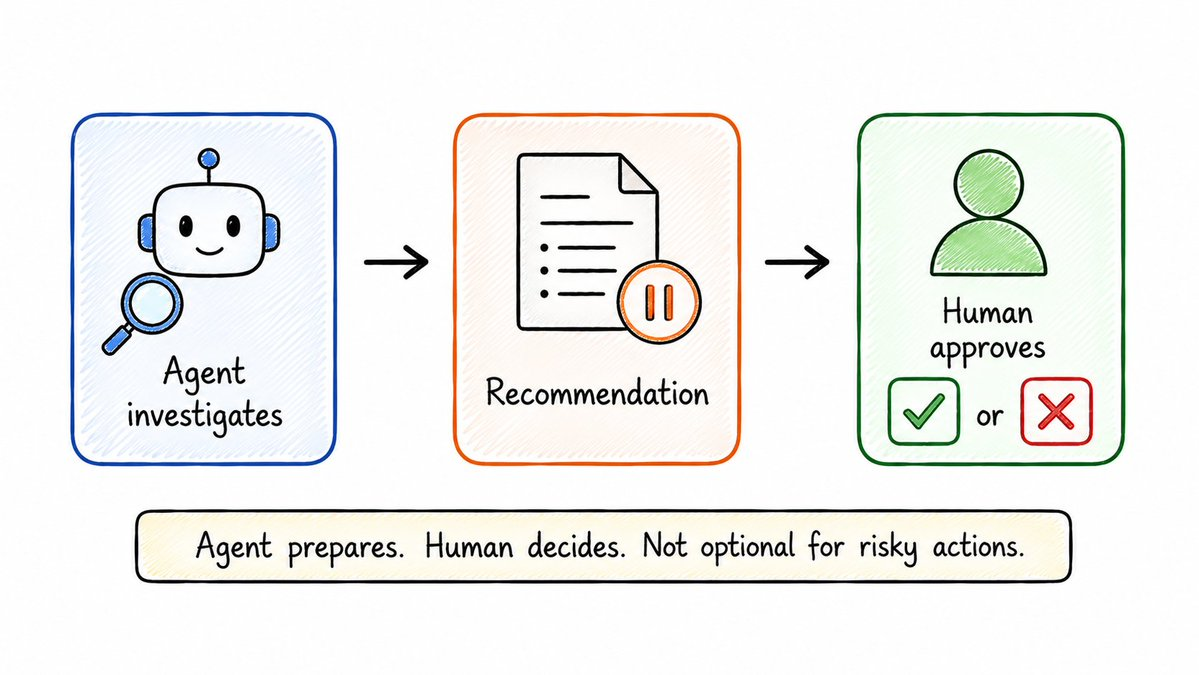
11、人在回路
Agent 调查 + 推荐;钱、法、声誉相关由人终审。
适用:全自动化不可接受,但想把调查与草稿自动化。
翻车:只做一个「暂停按钮」——缺持久状态、审派人、超时、升级路径,不是架构。
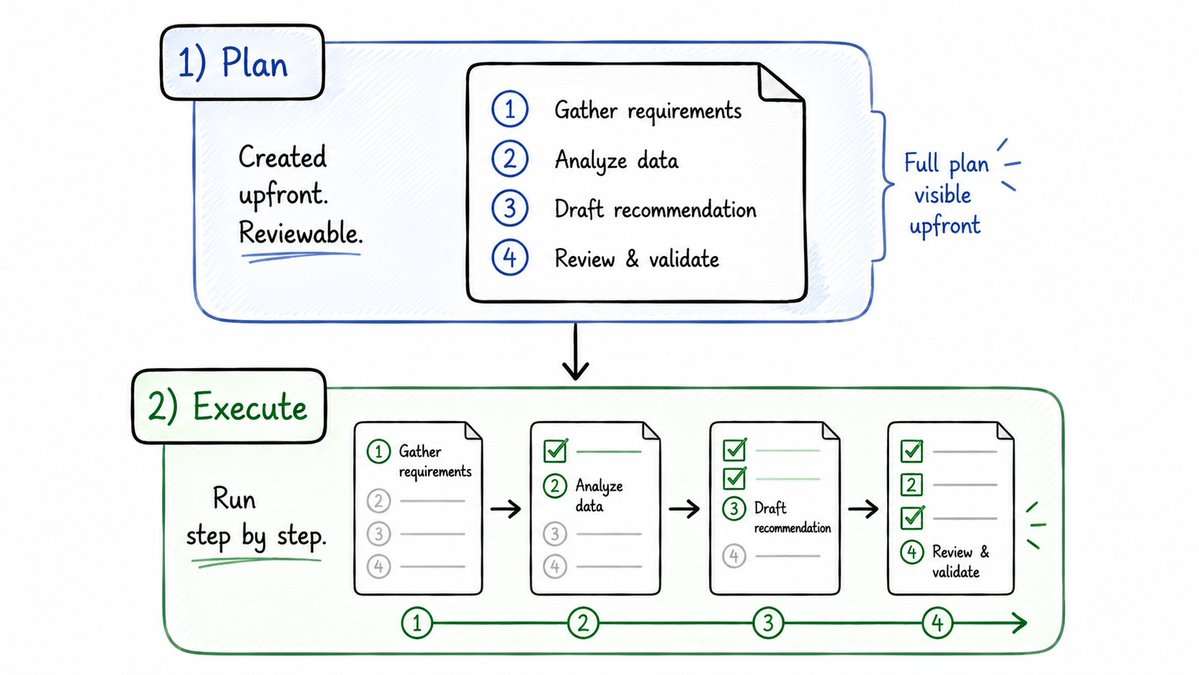
12、先规划后执行
规划 Agent 先出结构化、可改的计划;执行 Agent 再逐步跑。和 ReAct 对比:计划事先就可见。
适用:操作有后果,要先审计划再动手(运维、发布、扩缩容)。
翻车:环境变得比计划快——过时计划盲执行,比没计划更糟。
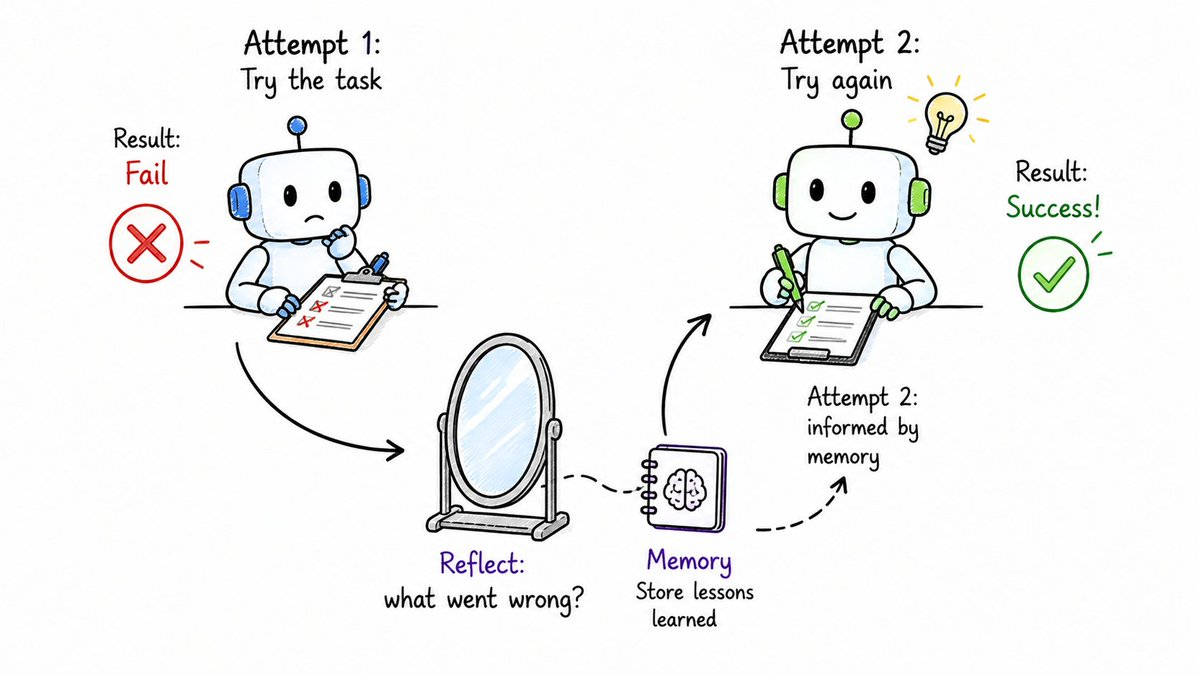
13、反思复试(Reflexion)
失败后分析、写入记忆、下一轮避免重复错误。
适用:失败信息量大,且失败模式可学习(代码、数据处理)。
翻车:失败随机、彼此无关——反思帮不上忙。
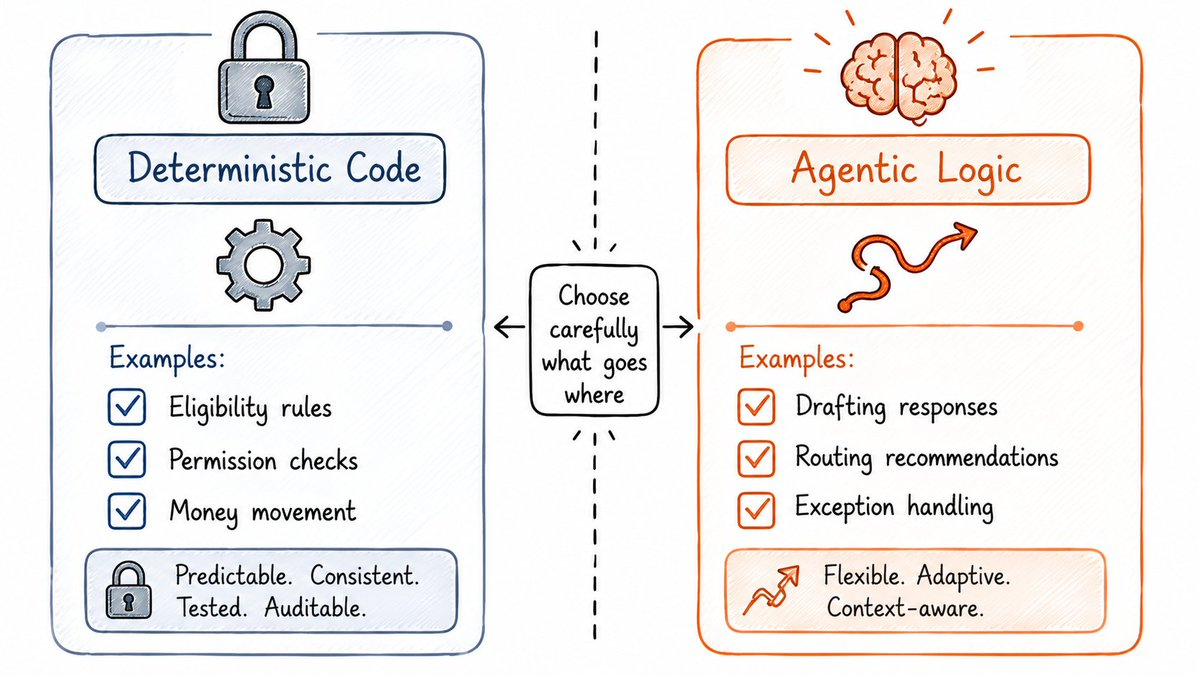
14、定制逻辑(混合)
确定性代码管绝不能错的分支;模型管判断、起草、例外。
适用:有法务/财务后果的分支逻辑;资格、权限、资金移动不能单靠模型。
翻车:该硬编码的交给模型——资格校验、打钱、改生产,必须走规则或人工把关。
Stripe、Claude Code 权限门控都是这个思路。
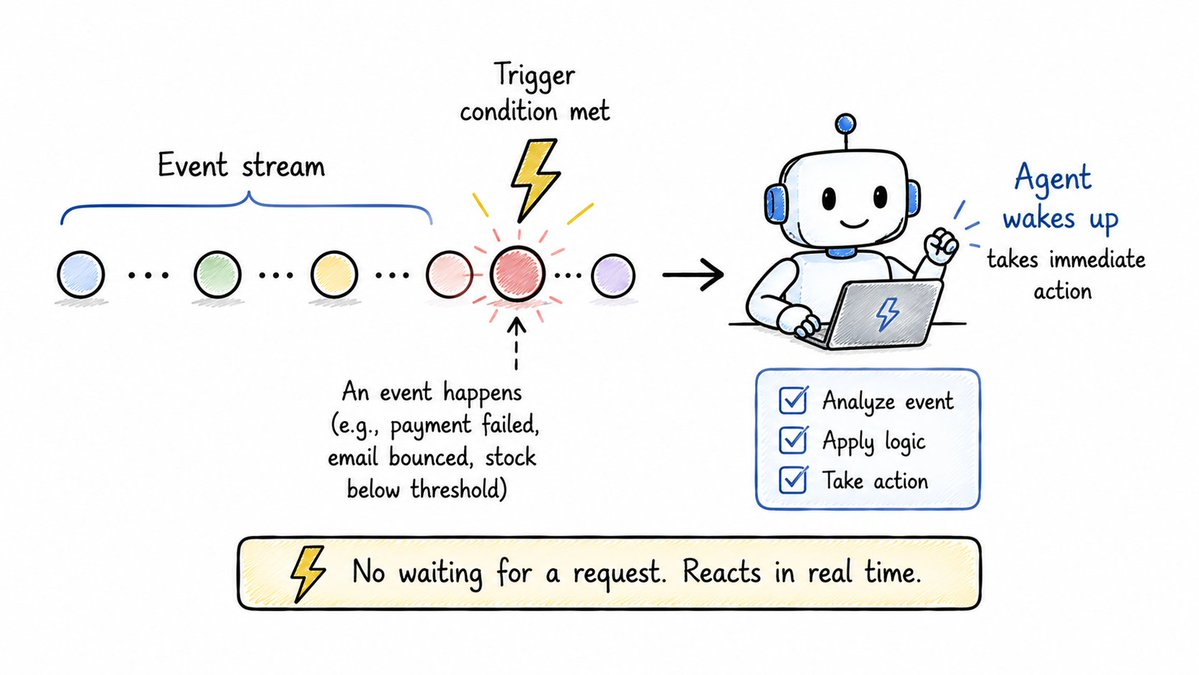
15、事件驱动
不等用户提问,订阅事件流,条件触发即行动。
适用:窗口期极短(欺诈、告警、库存异常)。
翻车:触发条件模糊 + 噪声事件多 → 狼来了,或漏真信号。
Codex 自动化任务、Claude /loop + webhook,可落这类。
三、按「不确定性」选型(对照表)
别追热度,追你在解哪种不确定场景:
蜂群不比单 Agent「高级」——任务只需一次可靠工具调用时,单 Agent 就对。
先规划后执行也不是 ReAct 的升级版——计划第三步就过时,ReAct 反而更合适。
最稳的生产系统,往往不是最自治的;自治只放在能创造价值的地方,其余一律约束。
四、生产环境 10 条铁律
-
从最小可用模式开始——工具契约清晰的单 Agent,胜过工具混乱的多 Agent
-
工具描述当契约写——模型只从 schema/描述知道工具干什么,读不到你的内心戏
-
给轮次、工具调用、单次消耗设上限——没预算上限的 Agent 是账单地雷
-
记录完整行动轨迹——工具、参数、输出、最终决策;没日志没法排障
-
不可逆动作走确定性检查或人工审批——打钱、改生产,模型不能是唯一闸门
-
用真实失败用例做评估——理想路径只是原型,边界才是产品
-
职责分开写 Prompt——系统提示里开始堆「但 Y 时不要 X」,说明 Agent 兼了两职,该拆模式
-
多 Agent 当分布式系统做——部分失败、超时、重试、可观测,不是可选项
-
模型 Review 不能替代确定性验证——裁判提质量,测试和权限检查保证正确性
-
优先更简单模式——省下的复杂度预算,花在更好的工具、Prompt、评估上
五、和本号其它篇怎么拼
Harness 搭好、Loop 跑起来、Review 写进循环——模式选错,三层都救不了。
六、我的判断
多数团队不是栽在「模式名字没背熟」,而是从没问清楚:自己在解哪种不确定性。
对我们这种用 Cursor / Claude Code / Codex 的人,实操路径很直白:
-
默认 单 Agent + 少工具 + 硬停止
-
质量不够 → 加 审查与批判 或 迭代精炼(别和生成用同模型、同提示词)
-
路径不可预知 → ReAct;要先审计划 → 先规划后执行
-
真要多专家 → 先 串行/并行 搞清楚依赖,再考虑 蜂群
-
有钱法风险 → 定制逻辑 + 人在回路,没有商量
选对模式,匹配问题,别在自治不创造价值的地方堆自治。
参考链接
-
原文素材:@sairahul1 —《15 种 Agent 设计模式:工程师必知》
-
Addy Osmani —《Loop Engineering》:https://addyosmani.com/blog/loop-engineering/
-
LangChain — The Anatomy of an Agent Harness:https://www.langchain.com/blog/the-anatomy-of-an-agent-harness
-
Matthew Berman — Loop 库 Loop Library:https://signals.forwardfuture.ai/loop-library/