你搭过 ReAct 循环,接了几个工具,Demo 跑得挺顺。
一上生产就翻车:模型忘了三步前干了啥,工具调用静默失败,上下文窗口塞满垃圾输出。你开始怀疑模型不行。
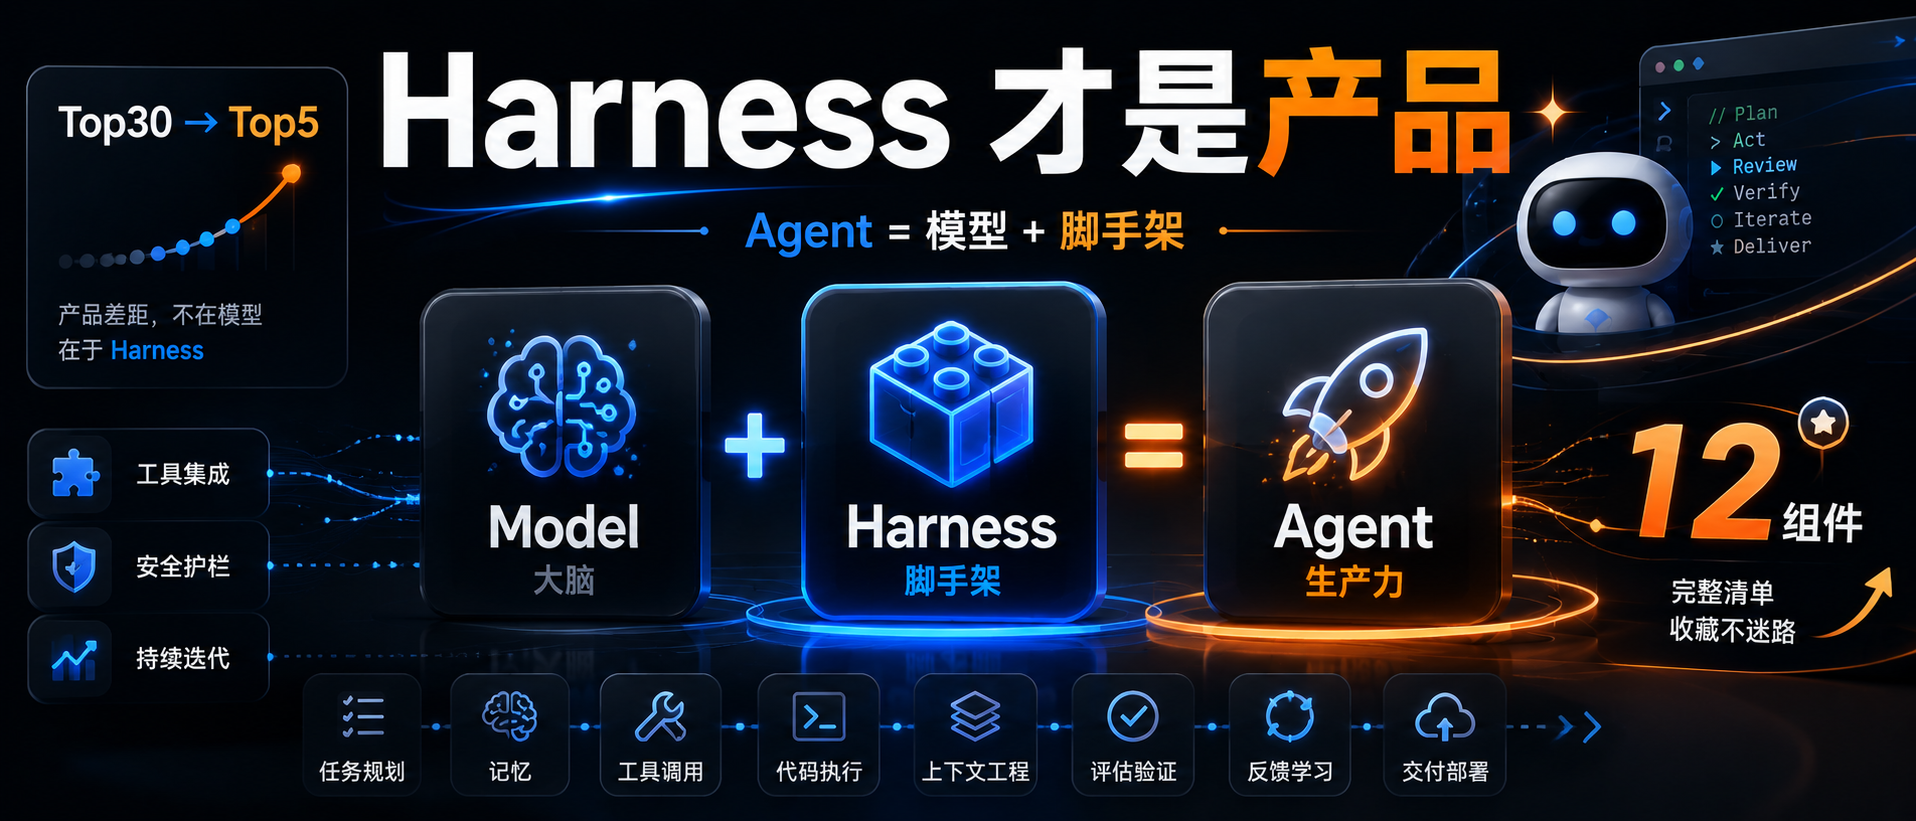
这大概率不是模型的问题,更可能的是模型外面那层「Harness(驾驭层)」没搭好。
LangChain 2026 年初有个硬证据:Deep Agents 在 Terminal Bench 2.0 上,模型权重不动(固定 GPT-5.2-Codex),只改 Harness——分数从约 52.8% 拉到约 66.5%,排名从 Top 30 外冲进 Top 5。斯坦福 IRIS 的 Meta-Harness 项目更狠:让 LLM 自己优化基础设施,固定模型下冲到约 76.4%,超过不少手工设计的系统。
这篇我们不写「一文读懂 Agent 架构」。写我们关心的:对于我们这种用 Cursor / Claude Code / Codex 的人,Harness 到底包什么、各家怎么实现、你怎么对照自己的项目查缺。
一、Agent 和 Harness:一句话分清
LangChain 的 Vivek Trivedi 有个公式我挺喜欢:
If you’re not the model, you’re the harness.(你不是模型,你就是驾驭层。)
用户看到的「Agent」——会规划、会调工具、会自我纠正——是涌现出来的行为。你实际写的是 Harness:循环、工具、记忆、权限、验证,全在这层。
Beren Millidge 2023 年那篇《Scaffolded LLMs as Natural Language Computers》把类比说透了:裸 LLM 像只有 CPU、没有内存和 I/O 的芯片;上下文窗口是 RAM(快但小),外部存储是磁盘(大但慢),工具是设备驱动,Harness 就是操作系统。
三层工程,从内到外:
之前写过《Loop Engineering》,Addy 把 Loop 放在 Harness 之上。可以这么记:Harness 是单车零件,Loop 是让车自己跑起来的调度系统。
二、生产级 Harness 的 12 个组件(对照表)
综合 Anthropic、OpenAI、LangChain 和一线实践,一套能上线的 Harness 通常有 12 块。不用全自建——Claude Code、Codex、Cursor 已经内置了大部分,关键是知道每块在干什么。
1、编排循环(Orchestration Loop)
心跳。经典是 ReAct / TAO(Thought-Action-Observation):组 Prompt → 调模型 → 解析输出 → 执行工具 → 结果塞回 → 重复。
Anthropic 管自家运行时叫「dumb loop」——聪明在模型里,循环只管回合。实现上它通常就是一个 while 循环,复杂度全在循环管什么。
2、工具(Tools)
Agent 的手。以 schema(名称、描述、参数)注入上下文,层里做注册、校验、沙箱执行、结果格式化。
Claude Code 覆盖文件、搜索、执行、网页、代码智能、子 Agent 等六类;Codex / OpenAI Agents SDK 支持函数工具、托管工具(WebSearch 等)、MCP 工具。
3、记忆(Memory)
多时间尺度。短期 = 当前会话历史;长期 = 跨会话:CLAUDE.md、MEMORY.md、LangGraph Store、Codex Sessions 等。
Claude Code 三层:轻量索引常驻、主题文件按需拉、原始 transcript 只搜不灌。设计原则:记忆是提示,行动前要对真实状态再核实。
4、上下文管理(Context Management)
静默翻车高发区。Chroma 和 Stanford「Lost in the Middle」都说明:关键信息掉在窗口中间,表现能掉 30% 以上。
常见手段:压缩(compaction)、遮蔽旧工具输出、即时检索(grep/glob 不全量读文件)、子 Agent 只回 1000–2000 token 摘要。Anthropic 的目标:用最少的高信号 token,换最大成功率。
5、Prompt 构造(Prompt Construction)
每步实际喂给模型的层次:系统提示 + 工具定义 + 记忆文件 + 历史 + 当前消息。Codex 有严格优先级栈:服务端系统消息最高,往下是工具、开发者指令、AGENTS.md(级联,单文件约 32 KiB 上限),再到对话历史。
6、输出解析(Output Parsing)
现代 Harness 靠原生 tool calling:模型返回结构化 tool_calls,有就执行、没有就结束。结构化输出用 Pydantic 等 schema 约束;老办法 RetryWithErrorOutputParser 仍可用于边角。
7、状态管理(State Management)
LangGraph 用类型化 state + checkpoint,可中断恢复、时间旅行调试。OpenAI 四套互斥策略:应用内存、SDK Session、服务端 Conversations API、previous_response_id 链。Claude Code 另辟蹊径:git commit 当检查点,进度文件当结构化草稿本。
8、错误处理(Error Handling)
10 步每步 99% 成功,端到端只剩约 90%。LangGraph 分四类:瞬态(退避重试)、LLM 可恢复(错误当 ToolMessage 还回去)、需人介入(interrupt)、意外(抛上去调试)。Stripe 生产 Harness 把重试上限卡在 2 次。
9、护栏与安全(Guardrails)
OpenAI 三级:输入 / 输出 / 工具护栏,tripwire 触发即停。Anthropic 把权限和推理拆开:模型决定想干什么,工具层决定允不允许。Claude Code 约 40 个独立工具能力门控,高风险操作要人点确认。
10、验证循环(Verification Loops)
玩具和生产的分水岭。Anthropic 推荐:规则验证(测试、linter、类型检查)、视觉验证(Playwright 截图)、LLM-as-judge(独立子 Agent 打分)。Boris Cherny 说过,给模型验证手段,质量能到 2–3 倍——这和《Agentic Code Review》里「证明比生成贵」是同一脉。
11、子 Agent 编排(Subagent Orchestration)
Claude Code:Fork(复制父上下文)、Teammate(独立终端 + 邮箱通信)、Worktree(独立 git 分支)。OpenAI:agent-as-tool vs handoff。LangGraph:嵌套 state graph。原则:先单 Agent 榨干,再拆。
12、(隐含)生命周期与终止
循环何时停:无 tool call、超轮次、token 预算、护栏触发、用户中断、安全拒绝。长任务跨窗口用 Anthropic「Ralph Loop」:Initializer 建环境 + 进度文件,后续每轮读 git log 和进度再动手——文件系统提供跨会话连续性。
三、一轮循环怎么走(7 步)
把上面 12 块串起来,一轮长这样:
-
组 Prompt:系统 + 工具 + 记忆 + 历史 + 用户消息(重要信息放头尾,防“中间丢失效应”)
-
调模型:出文本、tool_calls,或两者兼有
-
分类输出:无工具调用 → 结束;需要交接 → 切换到对应 Agent 重新开始
-
执行工具:校验参数、查权限、沙箱跑;只读可并发,写操作串行
-
打包结果:成功的观察结果, 或结构化错误(让模型自我纠正)
-
更新上下文:追加历史;快满则触发上下文压缩(摘要)
-
回到 1,直到终止条件命中
简单问答通常 1–2 轮;大规模重构可能要跑几十轮工具调用,才能把链条走完。
四、各家产品怎么落地(你大概已经在用)
OpenAI 自己说过:Codex 模型在 Codex 界面上往往比通用聊天窗好用——因为 Harness 是同一套,不是换个 API 端点。
LangChain Deep Agents 直接把「agent harness」写进产品名:内置 planning(write_todos)、虚拟文件系统、子 Agent、持久记忆、沙箱执行。
五、搭 Harness 必做的 7 个架构选择
每套 Harness 都要拍板这 7 件事(原文提炼成检查清单):
-
单 Agent vs 多 Agent — Anthropic 和 OpenAI 都建议:先把单 Agent 做到极致;工具重叠超 ~10 个或领域清晰分离再拆
-
ReAct vs Plan-and-Execute — 逐步推理灵活但贵;先规划再执行,LLMCompiler 报告约 3.6× 加速
-
上下文策略 — 清空、摘要、遮蔽、结构化笔记、子 Agent 五选一或组合;ACON 研究可减 26–54% token 仍保 95%+ 准确
-
验证设计 — 计算验证(测试)给确定性;LLM-judge 抓语义但慢。Fowler 团队叫 guides(行动前)和 sensors(行动后)
-
权限架构 — 宽松快但险,严格安全但慢,看部署场景
-
工具范围 — 工具越多常常越差;Vercel 从 v0 砍掉 80% 工具反而更好。Claude Code 懒加载可减约 95% 上下文
-
Harness 厚度 — Anthropic 赌薄 Harness + 模型变强;图框架赌显式控制。未来验证测试:模型变强时,不加 Harness 复杂度性能仍涨,设计就对了
六、我的判断
Terminal Bench 那组数据说明:同一模型,换 Harness 能差 20 名开外。 Harness 不是commodity 包装纸,是硬工程——上下文当稀缺资源管、验证环在错误复利前拦住、记忆给连续性但不幻觉。
趋势是 Harness 变薄(Manus 六个月重写五次,复杂工具定义收成 shell 执行),但不会消失。再强的模型也要有人管窗口、执行工具、持久状态、验证结果。
所以下次 Agent 翻车,别先换模型。按上面 12 块逐项查:循环有没有验证环?工具是不是灌太多?记忆当 hint 有没有核实?权限和推理有没有拆开?
如果你已经在用 Loop,下一步就是把 Judge / 验证 / 分诊 写进 Harness 设计里——和《Agentic Code Review》那篇是同一套世界观:写代码便宜了,证明和 Review 才是主业。
参考链接
-
LangChain — The Anatomy of an Agent Harness:https://www.langchain.com/blog/the-anatomy-of-an-agent-harness
-
LangChain — Improving Deep Agents with harness engineering:https://www.langchain.com/blog/improving-deep-agents-with-harness-engineering
-
Anthropic — Effective context engineering for AI agents:https://www.anthropic.com/engineering/effective-context-engineering-for-ai-agents
-
OpenAI — Agents SDK 文档:https://openai.github.io/openai-agents-python/
-
Claude — Dynamic workflows in Claude Code:https://claude.com/blog/a-harness-for-every-task-dynamic-workflows-in-claude-code