很多人把 Claude Fable 5 当成「上下文更大的 Sonnet」:写一段 Prompt,干五分钟,关标签页。
这样用,等于用跑马拉松的鞋跑去便利店买水。
Fable 5 是 6 月 9 日发的首款公开 Mythos 档模型——能力在 Opus 之上,定价也更高(API 约 $10 / $50 每百万 token,约为 Opus 4.8 的 2 倍)。Anthropic 设计它的 headline,是连续跑几天:跨阶段规划、派子 Agent、自己验活。
这篇把「自我改进 Agent 系统」拆成 14 步、三层。不逐字翻译海外长文,只留你能照着搭的东西。之前写过《Loop Engineering》和《Fable 5 该换还是继续 Opus》,这篇是下一层:怎么让系统一轮比一轮聪明。
一、先分清:自我改进 ≠ 自我学习
这两个词差一个字,意思差十万八千里。
自我改进靠的是:每轮把教训写进 STATE.md、写进 Skill、用 eval 收紧标准。模型还是那块模型;环境在复利。
Anthropic 工程团队原话大意是:别一直手动拽 Fable 5,不如设计 Loop,让它靠环境反馈自己纠偏(比如 /goal、Outcomes 那类「有判官的循环」)。
下面 14 步,就是把这个反馈环搭全。
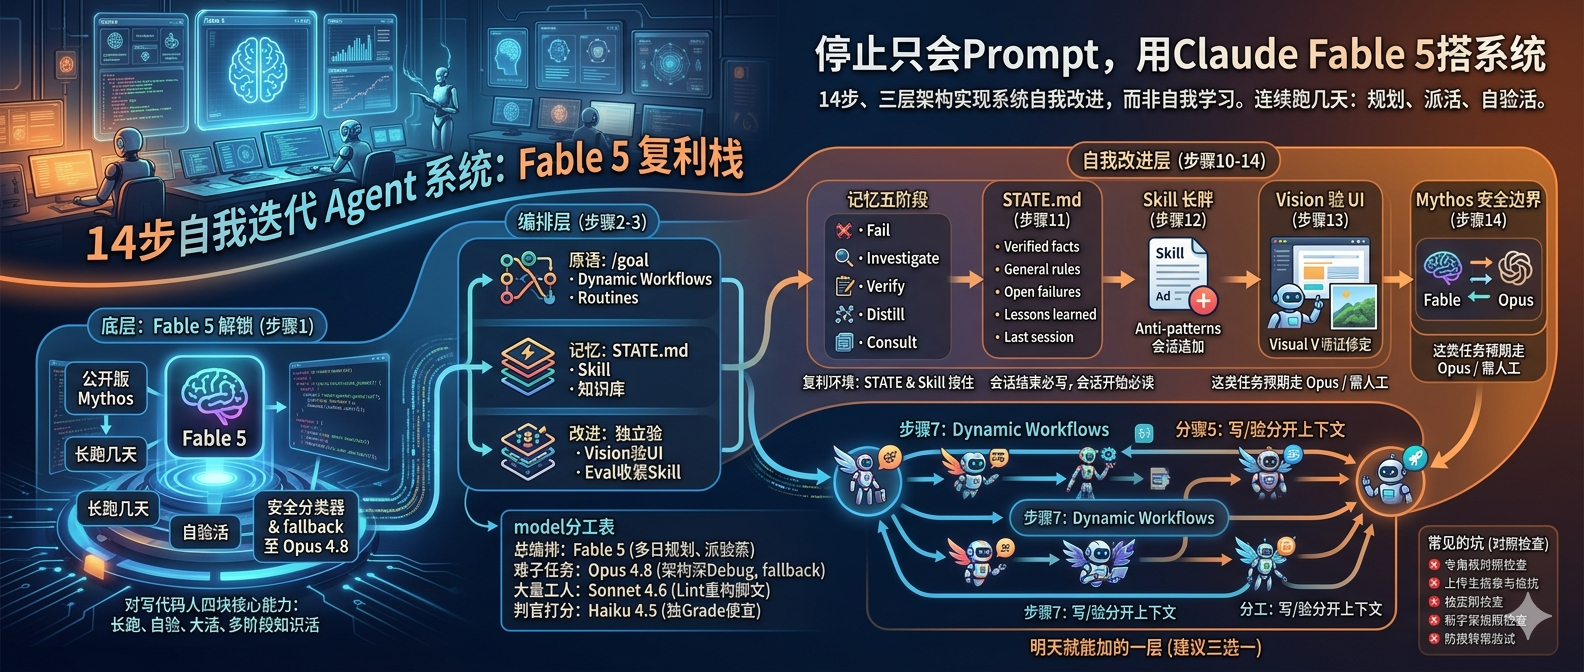
二、四层复利栈(步骤 1~4)
从底往上读——搭建顺序也建议从下往上。
1、底层:Fable 5 解锁了什么(步骤 1)
公开版 Fable 5 相对 Mythos 5(仅 Glasswing 等受信伙伴)多了安全分类器;敏感领域会自动 fallback 到 Opus 4.8——后面第 14 步会细说。
对写代码的人,官方强调的能力就四块:
-
长跑:在 Claude Code 或托管环境(CMA)里连续干很多轮
-
自验:自己写测试、用 vision 对照目标、把教训收成规则
-
大活:大迁移、多文件实现、少人盯着的交付
-
多阶段知识活:调研 → 成稿,中间少打断
单价贵,所以别全用 Fable 干杂活——步骤 4 的分工表很重要。
2、编排层(步骤 2~3 的概念)
-
原语:
/goal、Dynamic Workflows、Routines(云上的定时/事件触发) -
记忆:STATE.md、Skill、知识库
-
自我改进:独立验证者、vision 验 UI、eval 收紧 Skill
每一轮 Layer 1 的产出,往上走到 Layer 4 被打分、蒸馏,再写回 Layer 3。明天的新会话读的是昨天的文件,不是昨天的聊天。
3、模型分工:别全家 Fable(步骤 4)
生产里常见路由(可按你账单微调):
我平时的习惯跟《Fable 5 该换还是继续 Opus》里写的一样:日常 Sonnet/Opus,只有 /goal 长跑、大重构、多 worktree 并行才 /model fable。
三、三个原始能力:让 Loop 真的转起来(步骤 5~9)
1、/goal 和 Outcomes:同一思想的两种.harness(步骤 5~6)
形状一样:干活的 Agent 写结果 → 另一个 grader 判过没过 → 不过就下一轮 → 直到过或到上限。
步骤 6 的核心:别让 maker 自己批改自己。Anthropic 工程博客写过,Fable 5 配独立 verifier 子 Agent,比「请你再检查一遍」靠谱得多——模型会偏向自己刚写下的结论。
设计系统时默认:写的人和验的人分开上下文。我在《Claude Code 的 /goal》里讲过同一套哲学。
2、Dynamic Workflows:Claude 现场写编排脚本(步骤 7)
5 月 28 日前后,Claude Code 上了 Dynamic Workflows:Claude 根据任务现写一段 JS harness,里面用 agent()、parallel()、pipeline() 等原语派子 Agent,跑完再汇总。
对「自我改进」最有用的三个模式:
-
Fan-out-and-synthesize:拆成 N 份并行,各自干净上下文,再合成(例如给 Skill 里每条规则跑历史用例)
-
Adversarial verification:每个 maker 配一个没见过 maker 推理过程的 verifier
-
Loop until done:直到日志没新错、调研没新发现——再叠
/goal做硬停止条件
触发方式:Prompt 里说要 workflow,或用 **ultracode** 档位(/effort ultracode)。很费 token,适合大审计、大迁移,不适合改两行字。
3、Worktrees:并行不撞车(步骤 8)
多 Agent 改同一文件,和俩工程师没沟通就 commit 一样惨。git worktree / Claude Code 的 --worktree / subagent isolation: worktree 给每个 Agent 独立 checkout。
自我改进系统里:maker 在 A 树写,verifier 在 B 树读或只读验;Parameter Golf 那类实验,每个架构假设一棵 worktree,最后只 merge 赢家。
4、Routines:笔记本合上,Fable 还在跑(步骤 9)
Routines(研究预览)是把「Prompt + 仓库 + 权限 + 触发器」存成配置,在 Anthropic 云上跑。Fable「连跑几天」的度量,很多是在 Claude Managed Agents(CMA) 这类托管环境完成的,不是关盖就停的本地会话。
三种触发,对应三种复利:
-
定时:每天 7 点重跑 eval、把新失败写进 Skill、Slack 发摘要
-
API / 事件:CI 挂了自动调查、Sentry 告警自动分拣
-
GitHub:PR 打开跑 Skill eval,merge 后把新模式写回 Skill
本地可先 /loop + /goal 试逻辑,成熟了再迁 Routine。
四、自我改进层:记忆和 Skill 怎么复利(步骤 10~14)
1、记忆五阶段(步骤 10)
Anthropic Continual Learning Bench 实验里有个好框架——有效记忆不是「记一堆失败」,而是走齐五步:
-
Fail — 记录失败
-
Investigate — 查原因
-
Verify — 变成可核对的事实
-
Distill — 收成通用规则
-
Consult — 下次先读规则,别重推一遍
实验里 Sonnet 往往停在第 1 步(一堆「可能是 xxx?」);Opus 到第 3 步左右;Fable 5 更容易走完全程——前提是外面有 STATE 和 Skill 接住。
2、STATE.md:记忆真正落地的地方(步骤 11)
建议五块,和五阶段对齐:
## Verified facts      # 已验证,别再猜
## General rules       # 蒸馏后的通用规则
## Open failures       # 待查的失败
## Lessons learned     # 事后总结
## Last session        # 上轮停在哪,下轮接着干
两条铁律:
-
会话结束必写 — 没写就等于下轮重启
-
会话开始必读 — 不读,Fable 也会退化成「只有聊天、没有复利」
3、Skill 要会「长胖」(步骤 12)
STATE.md 是项目记忆;Skill 是跨项目的做法记忆。复利合同:确认过的教训写进 Skill,而不只留在当次对话。
跑两周的 CI 分拣 Skill,会多出 Known failure modes、Anti-patterns 段——那是真刀真枪踩出来的,比第一天写的静态说明值钱得多。
4、Vision 验 UI(步骤 13)
Fable 5 可以用 vision 对照目标验界面:maker 出码 → 截图 → verifier 读图对比 Skill 里的设计 token 和上轮 STATE 里的基准图 → 不过就退回改。
纯文本 grader 验不了「按钮有没有挤歪」——视觉任务要视觉验。
5、Mythos 安全边界(步骤 14)
网络安全、生物、化学、模型蒸馏等话题,Fable 5 可能被分类器拦下并 自动切 Opus 4.8。自我改进系统要显式处理 fallback,别把这种切换当成普通报错。
做安全相关 Skill 时,写清:「这类任务预期走 Opus / 需人工」。静默失败是最贵的 bug。
五、九个常见踩坑(对照检查)
-
把 Fable 当大 Sonnet,聊五分钟就关
-
让 maker 自己批改自己
-
没有 STATE.md,每轮从零开始
-
Skill 从不更新,失败不沉淀
-
用 Fable 改文档、跑 lint(该 Sonnet 干)
-
长跑只放笔记本上,合盖就断
-
忽略分类器 fallback,以为 Agent 坏了
-
UI 任务不用 vision 验
-
没有
/goal/ Outcomes 硬停止,停在「差不多行了」
六、明天就能加的一层
14 步不用一天搭完。按性价比,我建议三选一先上:
-
独立 verifier — 下一个
/goal就写清「判官用 Haiku,不得与 maker 同上下文」 -
STATE.md — 仓库根目录建文件,会话首尾强制读写
-
Vision 验 — 前端任务加「改完截图对比上一版」
自我改进是系统的属性,不是模型的魔法。Fable 5 只是把天花板抬高了;Loop、记忆、判官、Skill 才是复利本身。
如果你还没读过《Loop Engineering》,建议先那篇再这篇——五块积木是地基,这篇是往 Claude Fable 5 上盖二楼。
参考链接
-
Build self-improving agent system with Fable 5 in 14 steps : loops, dynamic workflows, routines:https://x.com/0xCodez/status/2065089060104720776
-
Anthropic — Claude Fable 5 and Claude Mythos 5:https://www.anthropic.com/news/claude-fable-5-mythos-5
-
Claude — Dynamic workflows in Claude Code:https://claude.com/blog/a-harness-for-every-task-dynamic-workflows-in-claude-code
-
Claude Code — Workflows 文档:https://code.claude.com/docs/en/workflows
-
Claude Code — /goal 文档:https://code.claude.com/docs/en/goal
-
Addy Osmani — Loop Engineering:https://addyo.substack.com/p/loop-engineering